

商业地产招商分析。商场运营方或品牌方需要全量掌握各大品牌的开店拓展需求(开店方式、面积要求),以便进行精准招商匹配。


点击空白处退出提示



商业地产招商分析。商场运营方或品牌方需要全量掌握各大品牌的开店拓展需求(开店方式、面积要求),以便进行精准招商匹配。
本项目旨在为商业地产招商、品牌选址及市场调研机构提供精准的数据支撑。系统基于 Scrapy 企业级爬虫框架搭建,能够实现对目标平台“赢商大数据”的全量品牌库进行自动化、高并发的遍历采集。
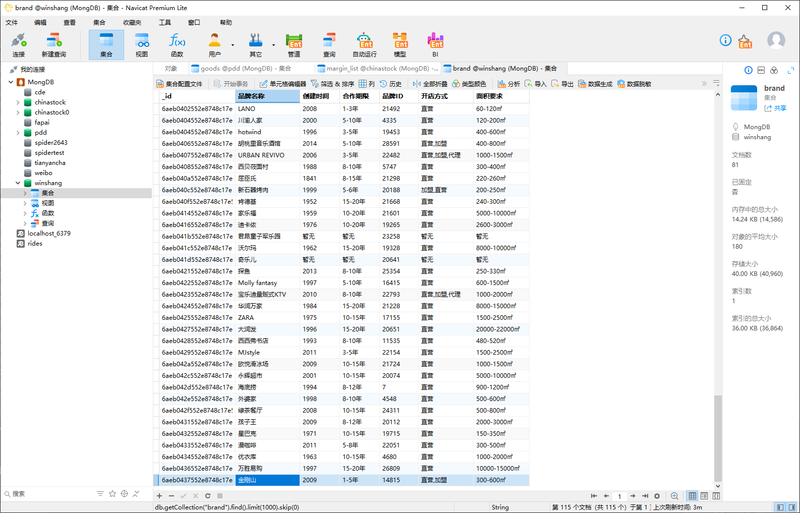
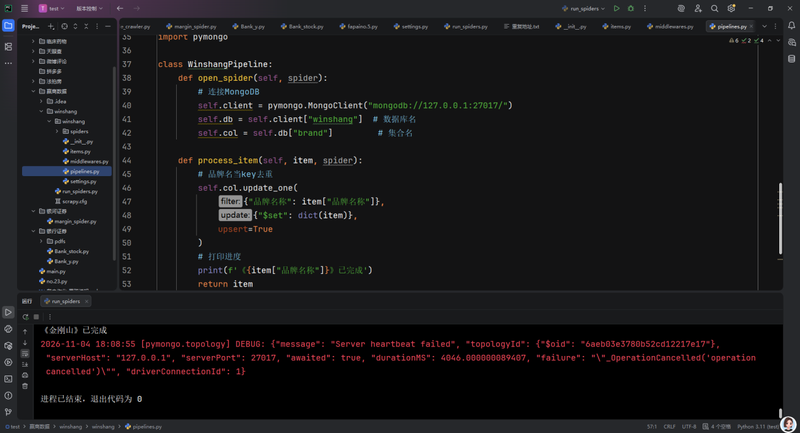
核心功能涵盖:多级页面穿透、全量品牌信息抓取、核心字段(品牌名、开店方式、合作期限、面积要求等)的精准提取,以及针对缺失数据的智能容错清洗。最终通过自定义的 Pipeline 管道,将海量结构化数据高效、异步地持久化至非关系型数据库 MongoDB 中,为前端的商业决策看板或数据挖掘大屏提供高质量的数据源。
技术栈:
· 语言与框架:Python 3.x、Scrapy(工业级爬虫框架)
· 数据解析:XPath
· 数据库:MongoDB(基于 Scrapy Pipeline 机制)
· 架构:自定义 Item、Spider、Pipeline 模块化开发
· 🧑💻 负责任务(项目内容):
1. Scrapy 工程架构搭建:独立创建 Scrapy 工程,完成 Settings 配置,编写 Spider 爬虫逻辑,实现企业级的数据抓取流水线。
2. 全量分类采集:分析目标站点 DOM 树,实现品牌列表页的自动翻页,完成不限分类的全量品牌数据抓取。
3. 数据清洗与缺省处理:使用 XPath 提取品牌名称、创建时间、开店方式、合作期限、面积要求等字段;针对“面积要求”缺失的情况,编写逻辑自动填补为“暂无”。
4. 自定义 Pipeline 落库:重写 Scrapy 的 Item Pipeline,将清洗后的品牌数据同步、高效地写入 MongoDB 数据库,确保数据无丢失。

评论