

医药研发情报分析、临床试验调研与竞品监测。医药企业、CRO(合同研究组织)或投资机构需要全面掌握各大药企的临床试验开展动态、在研药物管线及适应症布局,以便进行精准的研发决策、市场准入分析及商务拓展(BD)合作。


点击空白处退出提示



医药研发情报分析、临床试验调研与竞品监测。医药企业、CRO(合同研究组织)或投资机构需要全面掌握各大药企的临床试验开展动态、在研药物管线及适应症布局,以便进行精准的研发决策、市场准入分析及商务拓展(BD)合作。
本项目旨在为医药行业调研和数据分析提供精准的临床数据支撑。系统基于 Playwright 自动化测试框架搭建,能够对“中国药物临床试验登记与信息公示平台”的试验数据进行自动化、高稳定性的遍历采集。
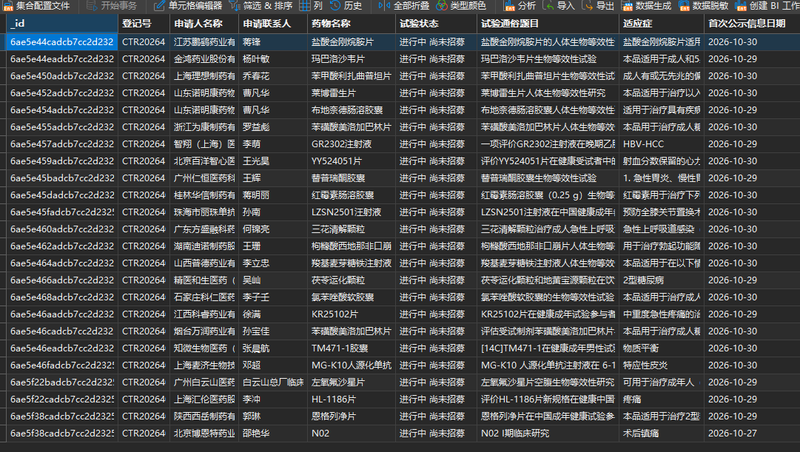
核心功能涵盖:列表与详情双层页面穿透、动态表单模拟翻页、核心字段(登记号、申请人、药物名称、适应症、试验状态等)的精准提取,以及针对复杂 DOM 结构(如表头对应值、Input 隐藏值)的智能容错解析。最终通过 PyMongo 管道,将海量结构化数据高效、异步地持久化至非关系型数据库 MongoDB 中,为前端的药物管线看板或数据挖掘大屏提供高质量的数据源。
技术栈:
语言与框架:Python 3.x、Playwright(自动化爬虫框架)、playwright-stealth(反反爬伪装)
数据解析:XPath、DOM 节点解析
数据库:MongoDB(基于 pymongo 驱动)
架构:模块化函数封装、表单 POST 动态翻页机制
👇 负责任务(项目内容):
Playwright 自动化框架搭建:独立配置 Playwright 浏览器实例,引入 playwright-stealth 插件隐藏自动化特征,绕过目标站点的安全校验,构建企业级的数据抓取环境。
动态翻页逻辑突破:分析目标站点 DOM 树,发现列表页为隐藏表单 POST 提交翻页。通过 page.evaluate 注入 JavaScript 代码,利用 setTimeout 延迟修改表单参数 currentpage 并触发 form.submit(),配合 expect_navigation 完美实现平稳翻页。
列表页与详情页穿透采集:遍历列表页表格,动态定位“CTR”登记号所在列,利用切片精准获取后续 4 个核心字段;同时监听 popup 事件,点击链接进入新标签页的详情页,获取联系人、首次公示日期等深层字段,实现多页联动。
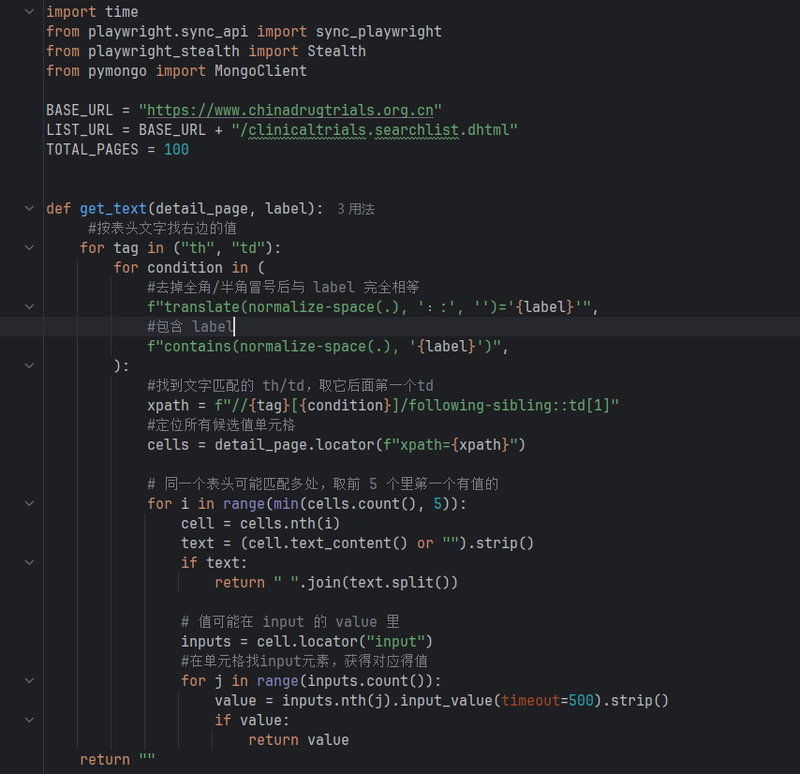
复杂 DOM 结构解析与数据清洗:针对详情页表格结构,编写 get_text 通用提取函数。通过 translate 去除全角/半角冒号并匹配表头,智能兼顾 td 文本与 input 的 value 值提取。针对列表页“药物名称”中夹杂“曾用名”的脏数据,编写逻辑进行自动截断清洗。
MongoDB 高效落库:重写数据组装逻辑,以“登记号”作为唯一标识,使用 update_one 配合 upsert=True 将清洗后的数据同步至 MongoDB。实现了数据的自动去重与增量更新,确保数据无丢失。

评论