语言技术
Python、HTML5、Torch系统类型
Web、算法模型行业分类
企业服务、金融参考价格
10000演示地址
https://github.com/liuq789/financial-table-ocr
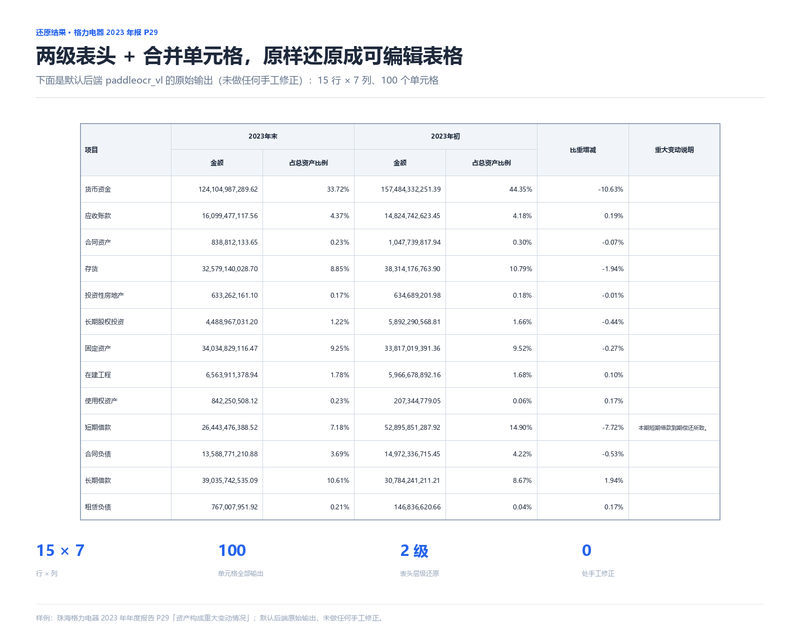
券商研究所、基金、会计师事务所和银行信贷、审计部门每天要处理成百上千页中文财报,包括年报、审计报告、募集说明书。这些文档的核心数据几乎全在表格里,例如资产负债表、所有者权益变动表、附注明细;而这类表格恰恰是最难识别的一类:两级甚至三级表头、大范围合并单元格、没有竖线、跨页续表、数字带千分位和括号负数。传统 OCR 只输出文字行,人工还得按坐标一行行对回去;一页 100 格的表要校对十几分钟。本项目要解决的就是把这类表格直接变成可编辑、可入库的 Excel 和 JSON:结构(合并关系)和数字一起还原,下游无论做数据入库、同行业对比还是喂给 RAG 检索,都不需要再人工重排。
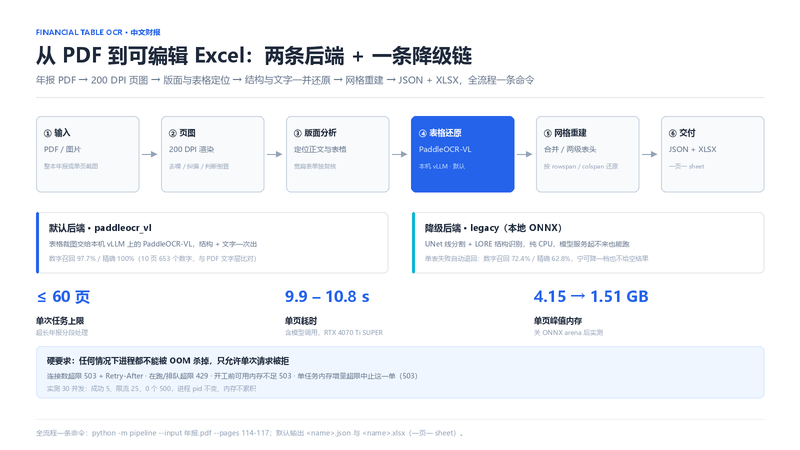
① 批量文档处理:上传整本年报 PDF 或单页图片,系统按页切分、纠偏、去噪,单次最多处理 60 页;
② 版面分析:定位正文与表格区域,对宽扁表单独复核,避免把段落误判成表格;
③ 表格还原(双后端):默认把表格裁图交给本机 vLLM 上的 PaddleOCR-VL,一次输出结构与文字;单表失败自动退回本地 ONNX 的 legacy 链路(UNet 线分割 + LORE 结构识别);
④ 结构化导出:同时产出 JSON(页码、表格 bbox、每格 rowspan/colspan、坐标、文字)与 XLSX(一页一 sheet,合并按原样合并、数字右对齐、表外正文按行铺);
⑤ 双入口:浏览器上传后直接查看「概览 / 完整 Excel / 完整 JSON」三个标签,也可以用一条命令跑指定页;
⑥ 资源保护:有界并发 + 有界排队 + 内存预算,过载时只拒单(429 / 503),进程永远不会因为 OOM 被杀。
我独立完成了全流程:PDF 解析与页图渲染、版面分析、表格结构与文字还原、多后端抽象与降级、Excel 导出、Web 服务与资源保护,以及评测脚本。
技术栈:Python / PyMuPDF / OpenCV / PaddleOCR-VL(vLLM 部署)/ ONNX Runtime / openpyxl / 标准库 HTTP 服务。
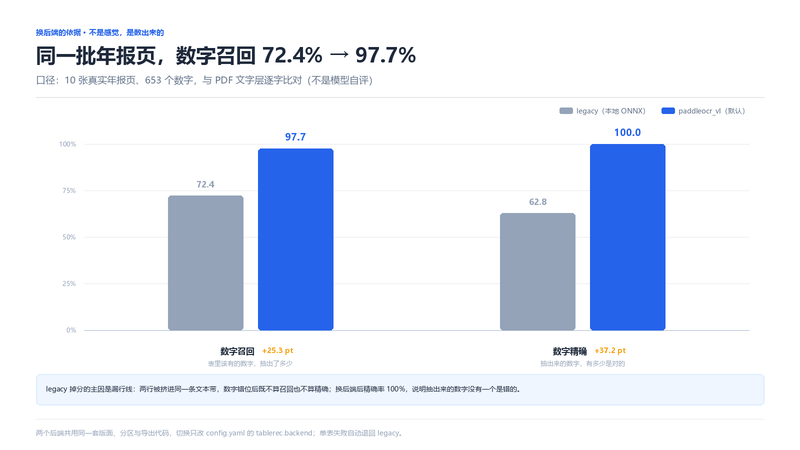
亮点:① 双后端解耦:legacy(UNet 线分割 + LORE,纯 CPU)与 paddleocr_vl(GPU)共用同一套版面、后处理和导出代码,切换只改 config.yaml 一个字段,单表失败自动降级,调用方无感知;② 换模型不是凭感觉,我用「10 张年报页、653 个数字,与 PDF 文字层逐字比对」做评测,数字召回 72.4% → 97.7%、精确 62.8% → 100%,才决定默认后端;③ 单页峰值内存从 4.15GB 压到 1.51GB:定位到 onnxruntime 默认 arena 按 2 的幂预占且不归还,改为关 arena、关 memory pattern、4 线程,耗时不变;实测 30 并发下成功 5、限流 25、0 个 500,进程 pid 不变、内存不累积;④ 上传走流式解析,不把整份文件读进内存,页与页之间做内存预算,超预算只中止当前这一单。
难点:中文财报的表格混合了有线和无线(三线表)两种形态,线检测在无线表上直接失效,只能走结构识别;而两级表头的合并关系一旦还原错,整张表的语义就全错了,所以合并关系(rowspan/colspan)是验收的第一指标,比文字准确率更靠前。
项目链接:GitHub - liuq789/financial-table-ocr: 财报表格识别:PDF / 图片 → 结构化 JSON + 可编辑 Excel。还原合并单元格、多级表头、无线表。 Financial ta
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论