

在做接口对接、固件通信分析与竞品协议研究时,经常会遇到没有任何文档的私有二进制协议。人工逐字节比对多条报文既慢又容易遗漏,而通用抓包工具只做展示、不做结构推断。本项目面向逆向分析与协议对接场景,输入若干条同格式报文,自动输出字段边界与语义假设,作为人工分析的起点,显著缩短协议还原的前期时间。


点击空白处退出提示



在做接口对接、固件通信分析与竞品协议研究时,经常会遇到没有任何文档的私有二进制协议。人工逐字节比对多条报文既慢又容易遗漏,而通用抓包工具只做展示、不做结构推断。本项目面向逆向分析与协议对接场景,输入若干条同格式报文,自动输出字段边界与语义假设,作为人工分析的起点,显著缩短协议还原的前期时间。
工具包含三个模块:
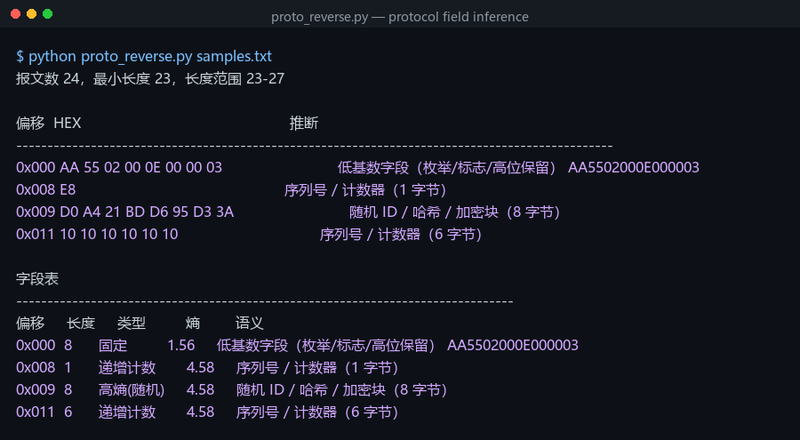
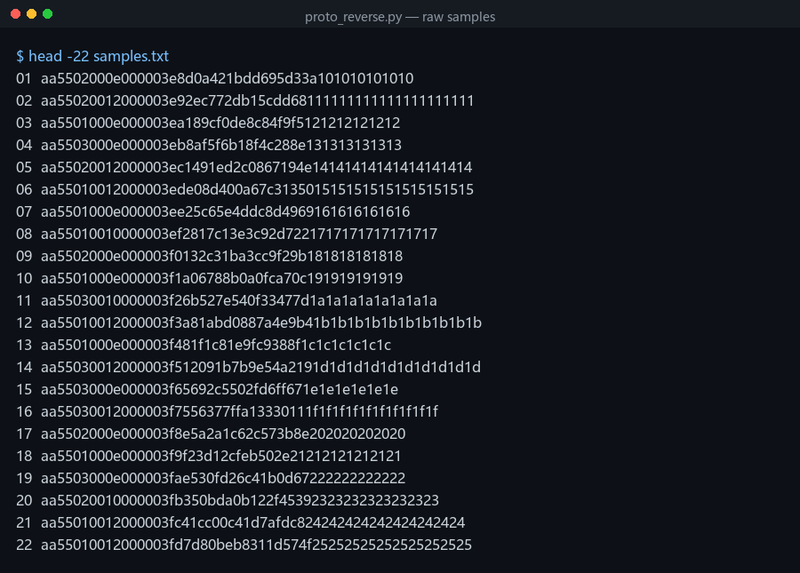
一、列对齐统计模块。把多条报文按偏移对齐,对每个字节位置计算唯一值数量、Shannon 熵与均值,形成逐列的统计特征。
二、字段分段模块。依据列特征做聚类,把相邻同类列合并为一个字段,自动区分固定值、低基数字段、严格递增序列与高熵随机段。
三、语义推断模块。结合分段结果给出字段用途假设:固定前缀多为魔数或协议版本,严格加一的序列多为报文序号或计数器,高熵段多为随机标识或加密块;同时对长度敏感字段做相关性检验,把字段值与报文总长做匹配,命中率超过阈值即判定为长度字段。
最终输出带偏移标注的十六进制视图与字段表,可直接作为逆向笔记使用。
独立完成算法设计与实现。
难点在于分段边界的判定:如果按单一阈值切分,常量区与枚举区会被割裂,导致字段碎片化,输出无法与人的观察一致。最终采用先归类再合并的两阶段策略,把常量与低基数列统一视为固定字段,再按特征边界切段。
长度字段识别则通过统计相关性而非固定偏移假设实现,使工具能适应不同的协议布局。全部逻辑用 Python 标准库实现,单文件可运行,便于在分析现场直接使用。

评论