

日常学习和办公中,经常需要把纸质资料、课件板书、屏幕上的文字转成电子文本,手动录入耗时且易出错。市面多数 OCR 应用依赖云端识别,存在隐私泄露风险,断网时也无法使用。本项目立项旨在做一款完全离线的拍照识字工具:拍照或选图后框选需要的区域,即可在设备本地完成中文 OCR,结果可编辑、复制并导出 TXT,全程不联网、不上传图片。适用于课堂笔记整理、会议记录、纸质资料电子化等对隐私和离线可用性有要求的场景。


点击空白处退出提示



日常学习和办公中,经常需要把纸质资料、课件板书、屏幕上的文字转成电子文本,手动录入耗时且易出错。市面多数 OCR 应用依赖云端识别,存在隐私泄露风险,断网时也无法使用。本项目立项旨在做一款完全离线的拍照识字工具:拍照或选图后框选需要的区域,即可在设备本地完成中文 OCR,结果可编辑、复制并导出 TXT,全程不联网、不上传图片。适用于课堂笔记整理、会议记录、纸质资料电子化等对隐私和离线可用性有要求的场景。
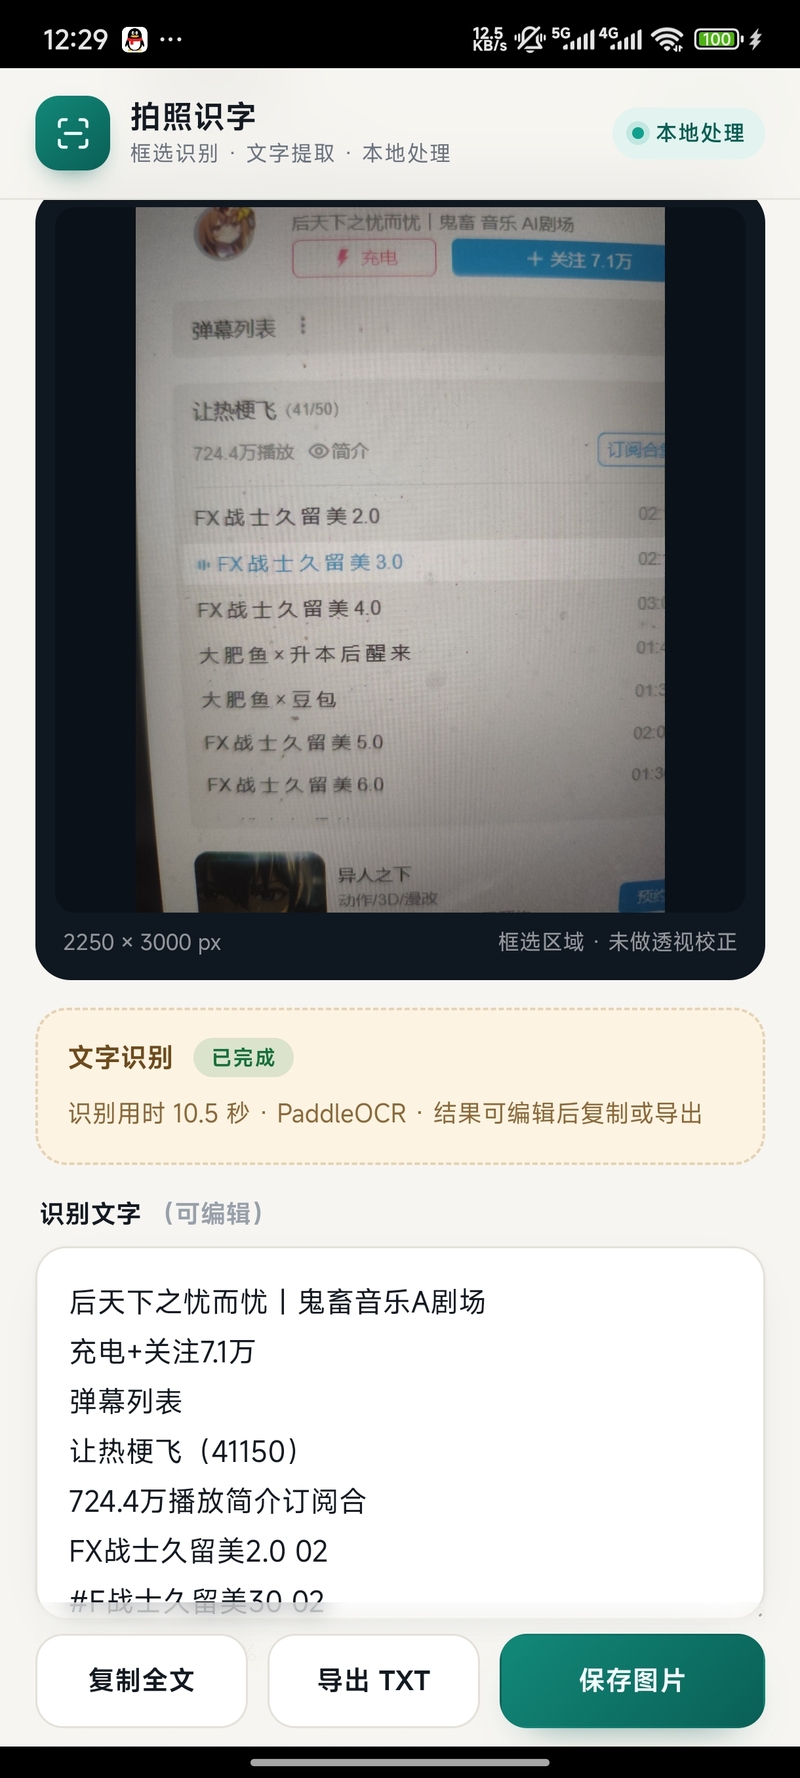
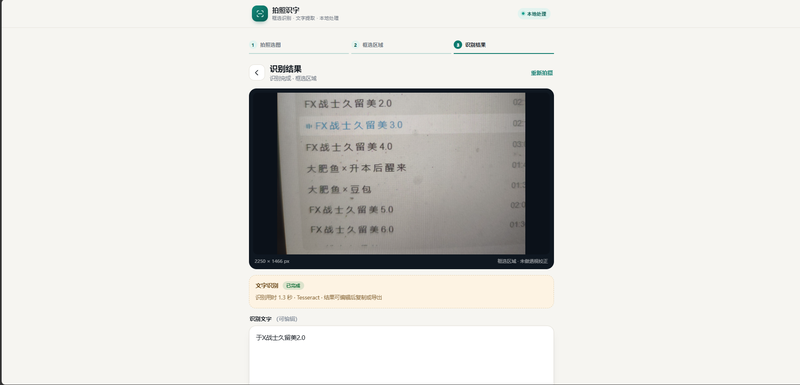
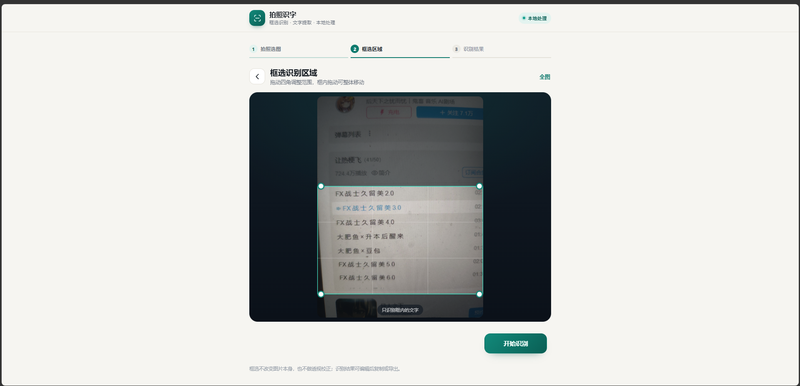
项目包含网页版与 Android App 两个形态,功能模块包括:1.图片导入:支持拍照、相册选图、拖拽上传,超大图片自动压缩;2.区域框选:可拖动整体、拉伸四角的裁选框,支持一键全图,选区实时预览;3.本地文字识别:内置 PaddleOCR(PP-OCRv4)中英文模型,在设备端完成文字检测与识别,另附 Tesseract 备用引擎自动回退,全程离线;4.结果编辑:识别文字在可编辑文本框中展示,可手动修改;5.结果导出:一键复制、导出 TXT 文件、保存识别区域图片;6.识别反馈:实时进度条,并显示字数、置信度、识别耗时与所用引擎。
本人独立完成需求分析、UI 设计、前端开发、OCR 引擎接入与 Android 打包的全流程。技术栈为 HTML/CSS/JavaScript + Canvas 2D,OCR 采用 onnxruntime-web(WebAssembly)加载 PP-OCRv4 检测与识别 ONNX 模型,Android 端以 Capacitor + Java 壳封装为离线 APK。整体为纯前端四层架构:UI 层、流程控制层、OCR 引擎层、模型资源层,无服务端。实现上的亮点与难点:1.在浏览器中完整实现 DB 文字检测的后处理(概率图阈值化、连通域分析、二阶矩定向框拟合、框外扩)与 CRNN 的 CTC 解码;2.处理原图、显示画布、模型输入三套坐标系的映射,框选区域采用归一化坐标存储避免错位;3.通过 WASM 单线程 SIMD 推理与模型资源精简,在无网络环境下兼顾识别准确率与安装包体积。

评论