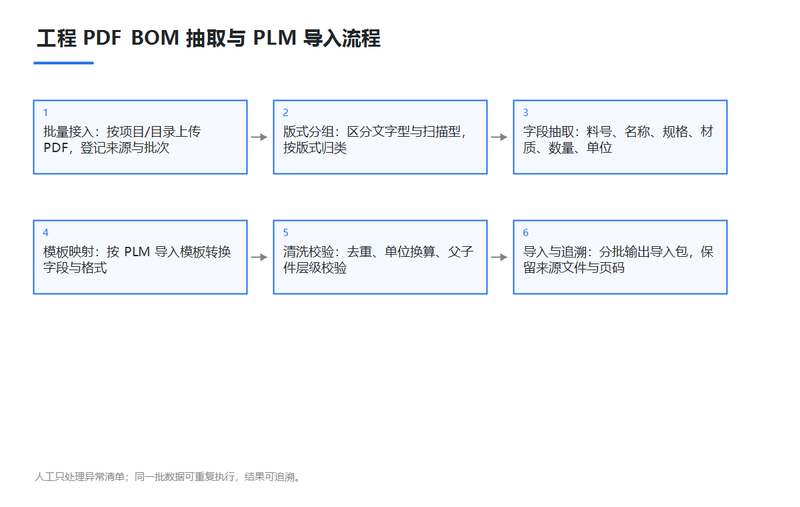
制造与工程行业里,BOM(物料清单)长期以 PDF 图纸和表格形式分散在研发、工艺、采购等部门。人工要把 3,000 份文件逐份打开、对照、抄录成 PLM 导入模板,原计划需 6 个月。本项目的立项原因,就是把这段重复劳动变成一条可复用的抽取与校验流水线:先批量解析 PDF,再抽取料号、名称、规格、材质、数量、单位等字段,按 PLM 模板转换,导入前完成去重与层级一致性校验,让人工只处理异常项。行业背景是工程制造企业的数据迁移与 PLM 上线,数据量大、版式多、错误代价高,因此自动化之外还必须保留来源追溯与人工复核。
系统分为四个功能模块。一、文件接入与版式分组:批量上传 PDF,区分文字型与扫描型,按版式归类后再抽取,减少逐份人工处理。二、BOM 字段抽取:从工程图纸与表格中提取料号、名称、规格、材质、数量、单位等字段,并保留来源文件与页码,便于回查。三、转换与校验:按 PLM 导入模板做字段映射,执行去重、单位换算、父子件层级与必填项校验,输出结构化异常清单。四、导入包生成:按批次输出可导入文件,异常项由人工复核后回填,形成从源文件到导入记录的完整闭环。
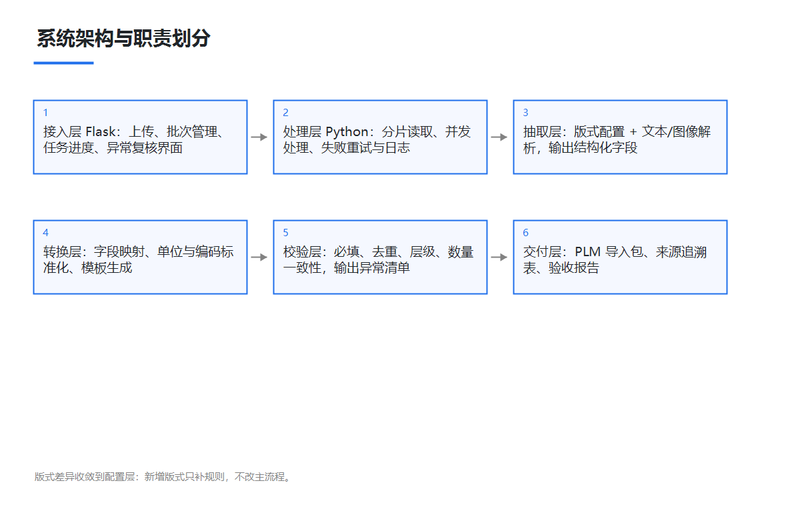
我负责从需求梳理到上线的全部环节:方案设计、数据盘点、抽取与转换脚本开发、UAT 支持、上线后改进,以及与工程、PLM 团队的接口定义。技术栈以 Python + Flask 为主体,按批次处理文件,抽取结果统一进入中间表后再做模板映射,保证同一份数据只解析一次、可重复执行。实现上的亮点是把版式差异收敛到配置层,新增版式只需补抽取规则而不用改主流程;难点是扫描件质量参差、同一字段存在多种写法,以及 BOM 父子层级在转换后容易断链。因此我把校验前置,用结构化异常清单驱动人工复核,最终约 3,000 份、200 GB 的文件在约 3 周内完成抽取、校验与导入,相比原估 6 个月大幅缩短。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论