

竞品价格与货架监测、公开名录与榜单整理、行业资讯结构化、网站数据迁移前的样例验证、研究用的公开样本采集


点击空白处退出提示



竞品价格与货架监测、公开名录与榜单整理、行业资讯结构化、网站数据迁移前的样例验证、研究用的公开样本采集
把网页上的非结构化内容变成可直接进表格的规范 CSV,并同时交代三件事:能不能采、采了多少、怎么复现。
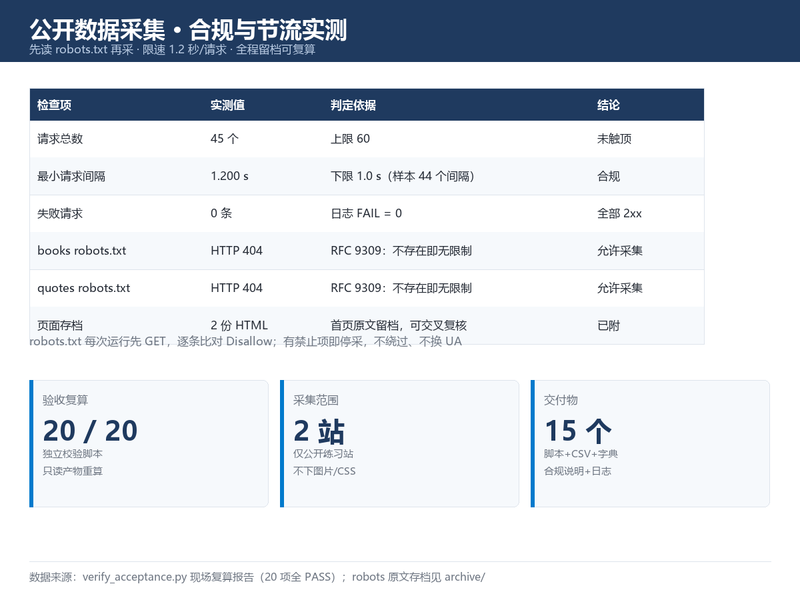
1. 每次运行先 GET 目标站 robots.txt,按 RFC 9309 判定:文件不存在(HTTP 404)视为无限制;若存在 Disallow 则逐条比对目标路径,命中即停并记录原因,原始响应正文存档备查,不靠嘴说「我合规」。
2. 限速抓取:请求间隔 ≥1.2 秒,串行不并发,使用真实 UA,不伪装搜索引擎,不访问目标域以外的资源(图片、CSS、字体一律不下载)。
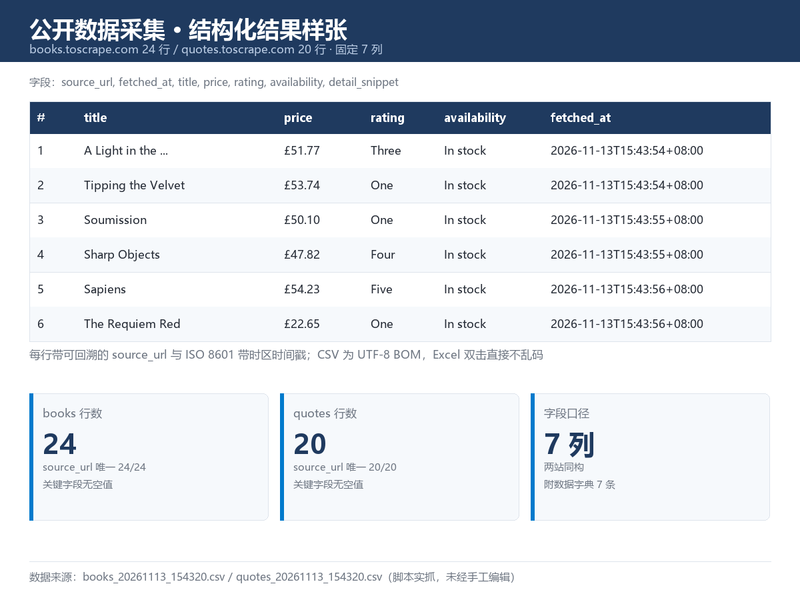
3. 结构化抽取:统一 7 列固定 schema——source_url(可回溯到具体页面)、fetched_at(ISO 8601 带时区)、title、price、rating、availability、detail_snippet,字段含义写进数据字典。
4. 交付前自检:独立脚本只读产物、重算 20 项硬指标——行数下限、source_url 去重后等于总行数、关键字段无空值、时间戳全部合规、请求数不超上限、最小间隔达标、日志无失败请求。
实测(两个公开的 web scraping 练习站):books 采集 24 行、source_url 唯一 24/24;quotes 采集 20 行、唯一 20/20;两表均 7 列且关键字段零空值;请求 45 个(上限 60)、最小间隔 1.200 秒(下限 1.0 秒,样本 44 个间隔)、失败 0 条;两站 robots.txt 均 HTTP 404,按 RFC 9309 判定无限制,原始响应已存档。
交付:脚本、两份 CSV(UTF-8 BOM,Excel 双击不乱码)、数据字典、合规说明(含 robots 判定依据原文)、完整请求日志、页面存档、验收脚本;换目标站只需改选择器与字段映射,限速与合规逻辑不用重写。
先读 robots.txt 按 RFC 9309 判定,限速 1.2 秒串行抓取,输出 7 列 CSV 与数据字典;校验 20 项全过,请求 45 个零失败。

评论