

面向大模型应用开发的评测与实验留证场景:团队常凭一次跑通的指标就下结论,缺少等预算对照与跨语料复现,容易把检索预算差异误记成编排收益。本项目用最小可运行闭环,把「改了什么、前后四行、哪句撤了」落进可复现记录,供协作与面试讲清边界。


点击空白处退出提示



面向大模型应用开发的评测与实验留证场景:团队常凭一次跑通的指标就下结论,缺少等预算对照与跨语料复现,容易把检索预算差异误记成编排收益。本项目用最小可运行闭环,把「改了什么、前后四行、哪句撤了」落进可复现记录,供协作与面试讲清边界。
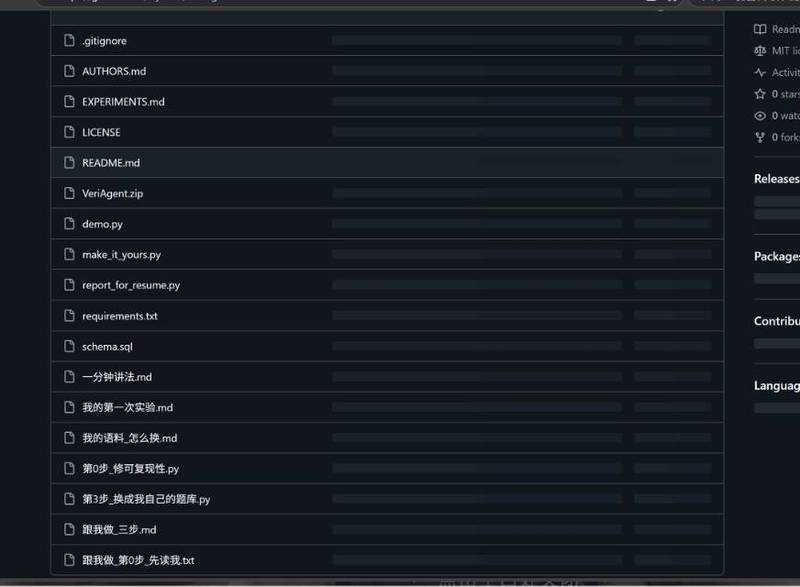
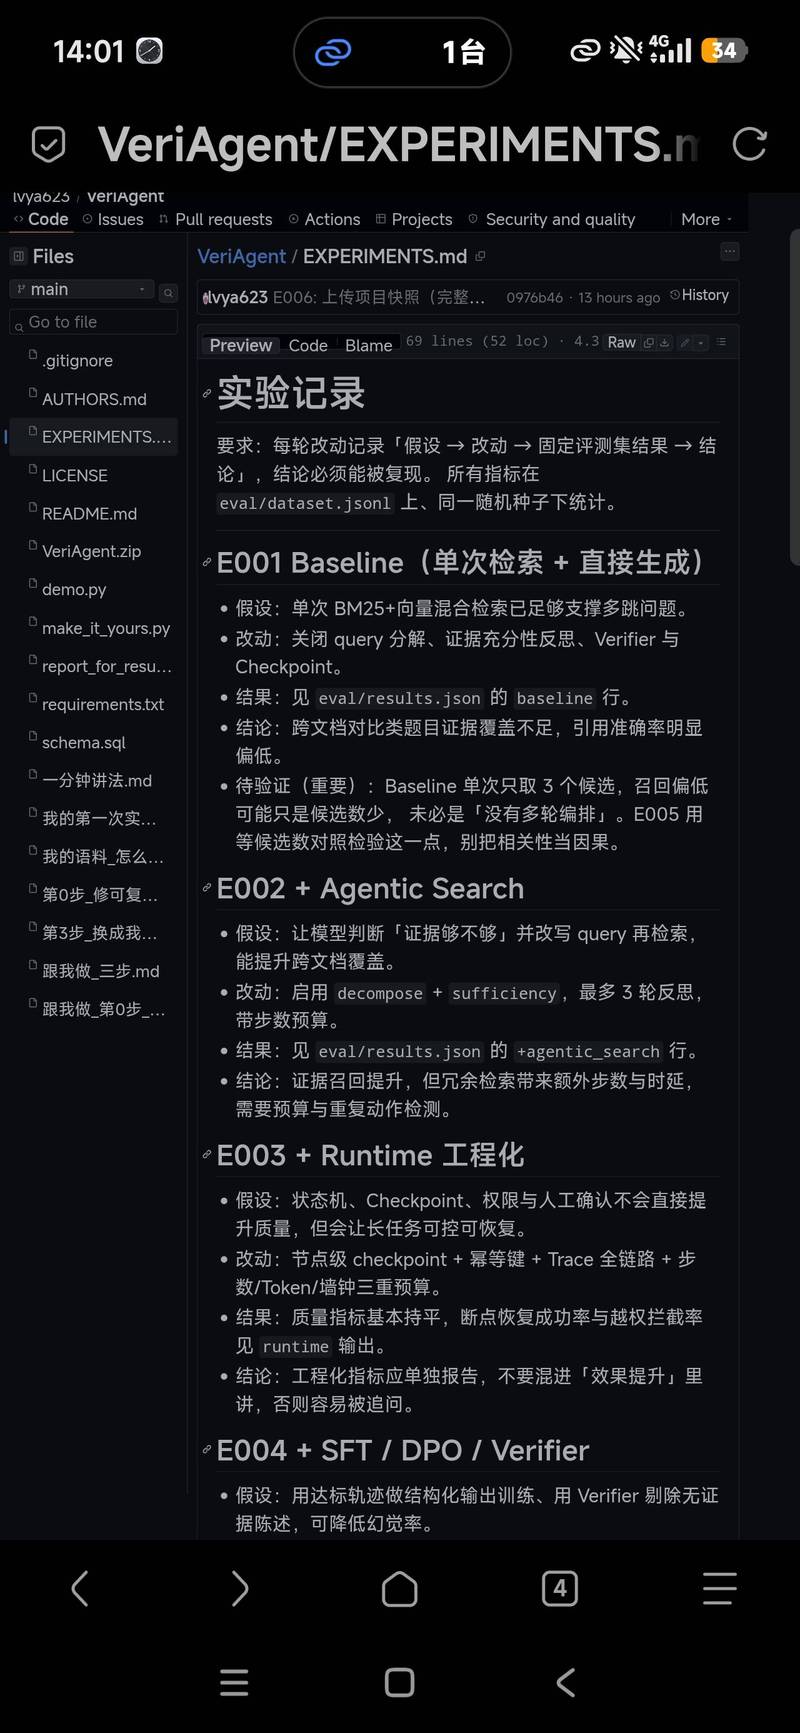
VeriAgent 最小可运行闭环,纯 Python 3 标准库、零第三方依赖、MockLLM、无需 API key,一条命令可复现。包含结构化 Planning 拆解、状态机与 Checkpoint 断点恢复、人工确认与权限拦截、全链路 Trace、混合检索与多轮 sufficiency 判断、Verifier 引用核验,以及评测脚本与结果文件。仓库首页 README 直接渲染,EXPERIMENTS.md 留 E005 等候选数对照与 E006 自建第二套语料复现,eval/results.json 存四行指标;VeriAgent.zip 保留 data / eval / veriagent 完整目录,解压后 python demo.py 即可跑通。
框架代码为最小参考骨架,不声称从零自造。我负责评测集设计、单变量消融与跨语料复现:自建 12题/8篇语料,把 Baseline topk 3→6 做等预算对照,发现原 65%→81% 召回提升来自检索预算不对等而非多轮编排,主动撤下该结论(E005);再换第二套语料复现(E006)。技术栈仅 Python 3 标准库 + Git + crc32 结果校验,难点在守住单变量、不把漂亮数字直接写进结论,全程留 EXPERIMENTS.md 与提交记录。

评论