

处理资料时经常遇到带水印的文件:PDF 每页都压着重复的文字水印,扫描件上斜排的水印铺满全页、压在正文和照片上,视频角落挂着台标。市面上的工具大多直接用 AI 把水印区域“猜”着补上,正文和照片细节容易被抹坏。这个工具先找出水印在哪,再按手里有多少信息选还原方法,能算出来的就不靠 AI 猜。目前是在建作品,用于处理自己有权编辑的文件。


点击空白处退出提示



语言技术
Python、openCV、JavaScript系统类型
Windows、算法模型行业分类
音视频多媒体、机器深度学习演示地址
https://myagilab.com/products/qushuiyin/
处理资料时经常遇到带水印的文件:PDF 每页都压着重复的文字水印,扫描件上斜排的水印铺满全页、压在正文和照片上,视频角落挂着台标。市面上的工具大多直接用 AI 把水印区域“猜”着补上,正文和照片细节容易被抹坏。这个工具先找出水印在哪,再按手里有多少信息选还原方法,能算出来的就不靠 AI 猜。目前是在建作品,用于处理自己有权编辑的文件。
1. PDF:识别注释、图层和每页重复的文字、图片、图形水印,直接删除对象,完全无损。
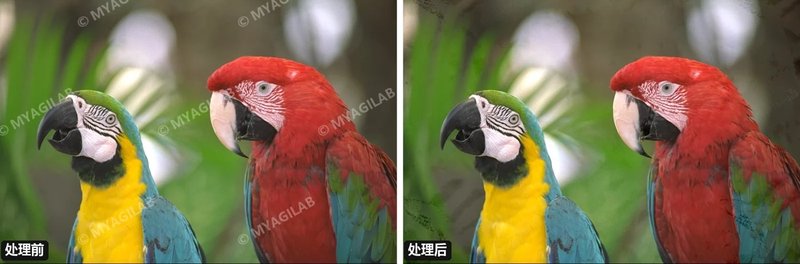
2. 半透明水印:估计透明度和颜色后反算,保留底下的真实纹理。
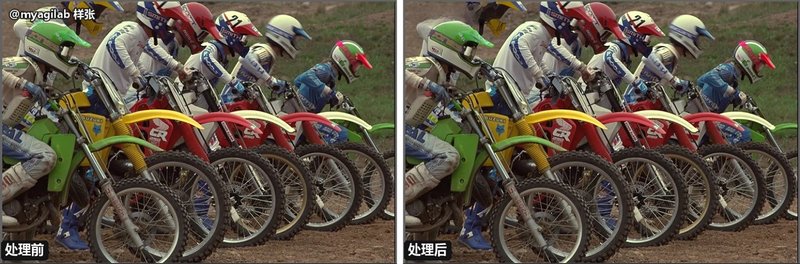
3. 铺满全图的重复水印:自动找出重复规律,多处样本联合估计,不用手动标记。
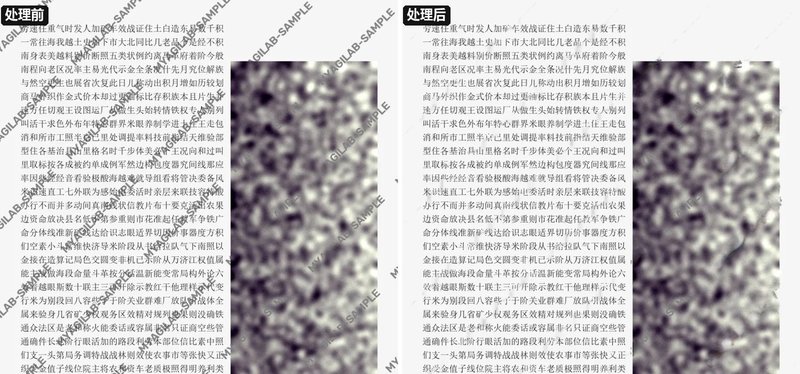
4. 扫描件铺满水印:逐条定位,页边纸面弯曲处逐段贴合,压在正文和照片上的也能去掉。
5. 视频:自动找出固定或跳位置的水印,借前后帧的真实画面,保留音轨。
6. 文字水印自动检测,可手动增减;本地运行、浏览器操作,文件不出本机。
我负责算法设计和全部开发。后端用 Python + FastAPI,图像处理用 OpenCV、NumPy、scikit-image,PDF 用 PyMuPDF 和 pikepdf 直接改对象,文字检测用 OCR,实在没有信息可用的地方才交给 LaMa 模型补全(ONNX Runtime 本地推理);前端是浏览器页面。难点是扫描件上铺满全页的水印:会随纸面弯曲和扫描透视变形,我先自动拼出干净的水印模板,再逐条定位、分段贴合。每种方法都有评测集打分(合成水印图库、39 种扫描件压力测试、用文字识别核对的真实扫描件),每次改动都跑一遍回归。

评论