

ELK日志系统接入与推广:推进ELK(Elasticsearch + Logstash + Kibana)分布式日志系统在公司多条业务线的接入与推广,统一日志收集、存储与检索规范,将故障排查效率提升约60%;同时推动部分业务系统核心大表接入Elasticsearch搜索引擎,通过索引优化与查询重构,将复杂查询响应时间从秒级降至毫秒级


点击空白处退出提示



ELK日志系统接入与推广:推进ELK(Elasticsearch + Logstash + Kibana)分布式日志系统在公司多条业务线的接入与推广,统一日志收集、存储与检索规范,将故障排查效率提升约60%;同时推动部分业务系统核心大表接入Elasticsearch搜索引擎,通过索引优化与查询重构,将复杂查询响应时间从秒级降至毫秒级
工业物联网的数据采集,负责收集物联网表具的上报数据,归纳和分析上报的频率成功率是否欠费的信息,以前真兰是没有一个统一的ELK日志分析平台,是我来了之后一个人完成了es集群的搭建和elk系统开发搭建 ELK 系统的核心思路是:让日志从分散的服务器汇聚到一个地方,统一存储、检索和可视化。ELK 由三个组件协同完成这件事:Elasticsearch 负责存储和检索,Logstash 负责收集和清洗,Kibana 负责可视化。
📐 架构与核心组件
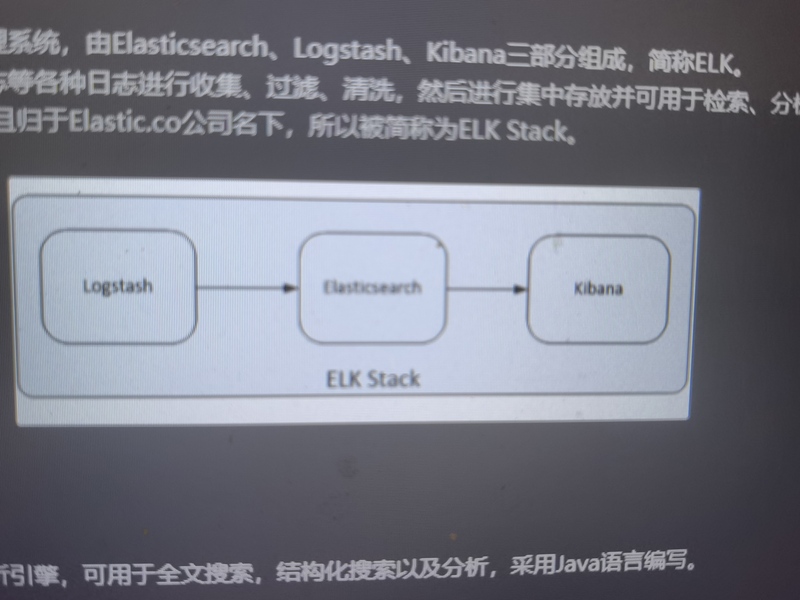
典型的 ELK 数据流是:日志源 → 采集/处理 → 存储/检索 → 可视化。现代实践中,通常会引入轻量级的 Filebeat 替代 Logstash 来采集日志(资源消耗更低),Logstash 则按需保留用于复杂的解析场景。
· Elasticsearch:分布式搜索引擎,负责存储日志并利用倒排索引实现毫秒级检索。
· Logstash:数据处理管道,通过 Input → Filter → Output 流程清洗非结构化日志。
· Kibana:Web 界面,用于查询日志、制作图表和告警。
· Filebeat:部署在日志源头的轻量采集器,直接转发给 Logstash 或 ES。
⚙️ 搭建步骤(以 Linux 单机为例)
环境准备
建议内存 ≥4GB(ES 默认占用 2GB 堆内存),并关闭防火墙或开放 9200(ES)、5601(Kibana)、5044(Logstash)端口。
部署 Elasticsearch(核心存储)
通过包管理器安装后,需调整系统参数(如 vm.max_map_count)并配置 elasticsearch.yml。启动后,用 curl localhost:9200 验证是否返回 JSON 信息。
部署 Kibana(可视化界面)
安装后修改 kibana.yml,将 server.host 设为 0.0.0.0 以允许远程访问。通过 http://:5601 访问。
部署 Logstash 与配置管道
安装后,编写管道配置文件(如 /etc/logstash/conf.d/logstash.conf)。这是 ELK 的核心逻辑所在,一个典型的配置结构如下:
```ruby
input {
beats { port => 5044 } # 接收 Filebeat 发来的数据
}
filter {
grok { # 使用 Grok 正则解析非结构化日志,提取字段
match => { "message" => "%{IPORHOST:client_ip} - %{DATA:user} \[%{HTTPDATE:timestamp}\] \"%{WORD:method} %{DATA:request}\" %{NUMBER:status}" }
}
}
output {
elasticsearch {
hosts => ["http://localhost:9200"]
index => "logs-%{+YYYY.MM.dd}" # 按日期生成索引
}
}
```
部署 Filebeat(采集端)
在产生日志的服务器上安装 Filebeat,修改 filebeat.yml 指定日志路径,并将输出指向 Logstash 的 5044 端口(或直接指向 ES)。
✅ 验证与使用
在 Kibana 的 Stack Management → Index Patterns 中创建索引模式(如 logs-*),然后进入 Discover 页面选择对应的时间范围,就能看到汇聚过来的日志数据了。你还可以在 Dashboard 中制作图表,或配置告警规则。
💡 两点建议
· 生产环境简化:如果日志格式简单,可以跳过 Logstash,直接用 Filebeat → Elasticsearch,能大幅降低维护复杂度。
· 快速验证:如果只是想体验一下,可以用 Docker Compose 一键拉起一个单机环境,比手动安装快得多。
搭建 ELK 系统的核心思路是:让日志从分散的服务器汇聚到一个地方,统一存储、检索和可视化。ELK 由三个组件协同完成这件事:Elasticsearch 负责存储和检索,Logstash 负责收集和清洗,Kibana 负责可视化。
📐 架构与核心组件
典型的 ELK 数据流是:日志源 → 采集/处理 → 存储/检索 → 可视化。现代实践中,通常会引入轻量级的 Filebeat 替代 Logstash 来采集日志(资源消耗更低),Logstash 则按需保留用于复杂的解析场景。
· Elasticsearch:分布式搜索引擎,负责存储日志并利用倒排索引实现毫秒级检索。
· Logstash:数据处理管道,通过 Input → Filter → Output 流程清洗非结构化日志。
· Kibana:Web 界面,用于查询日志、制作图表和告警。
· Filebeat:部署在日志源头的轻量采集器,直接转发给 Logstash 或 ES。
⚙️ 搭建步骤(以 Linux 单机为例)
环境准备
建议内存 ≥4GB(ES 默认占用 2GB 堆内存),并关闭防火墙或开放 9200(ES)、5601(Kibana)、5044(Logstash)端口。
部署 Elasticsearch(核心存储)
通过包管理器安装后,需调整系统参数(如 vm.max_map_count)并配置 elasticsearch.yml。启动后,用 curl localhost:9200 验证是否返回 JSON 信息。
部署 Kibana(可视化界面)
安装后修改 kibana.yml,将 server.host 设为 0.0.0.0 以允许远程访问。通过 http://:5601 访问。
部署 Logstash 与配置管道
安装后,编写管道配置文件(如 /etc/logstash/conf.d/logstash.conf)。这是 ELK 的核心逻辑所在,一个典型的配置结构如下:
```ruby
input {
beats { port => 5044 } # 接收 Filebeat 发来的数据
}
filter {
grok { # 使用 Grok 正则解析非结构化日志,提取字段
match => { "message" => "%{IPORHOST:client_ip} - %{DATA:user} \[%{HTTPDATE:timestamp}\] \"%{WORD:method} %{DATA:request}\" %{NUMBER:status}" }
}
}
output {
elasticsearch {
hosts => ["http://localhost:9200"]
index => "logs-%{+YYYY.MM.dd}" # 按日期生成索引
}
}
```
部署 Filebeat(采集端)
在产生日志的服务器上安装 Filebeat,修改 filebeat.yml 指定日志路径,并将输出指向 Logstash 的 5044 端口(或直接指向 ES)。
✅ 验证与使用
在 Kibana 的 Stack Management → Index Patterns 中创建索引模式(如 logs-*),然后进入 Discover 页面选择对应的时间范围,就能看到汇聚过来的日志数据了。你还可以在 Dashboard 中制作图表,或配置告警规则。
💡 两点建议
· 生产环境简化:如果日志格式简单,可以跳过 Logstash,直接用 Filebeat → Elasticsearch,能大幅降低维护复杂度。
· 快速验证:如果只是想体验一下,可以用 Docker Compose 一键拉起一个单机环境,比手动安装快得多。

评论