

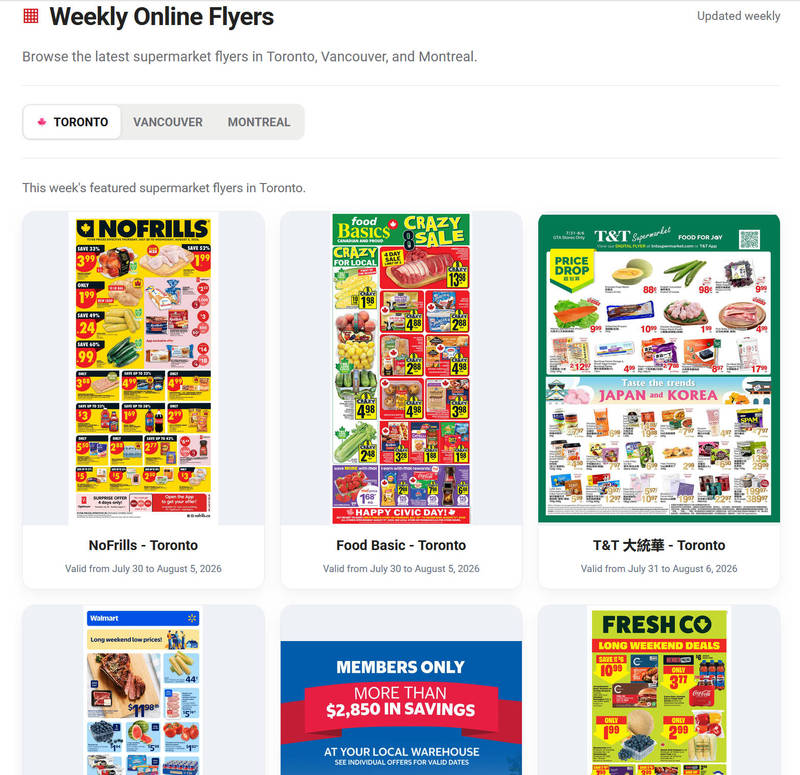
立项原因:零售优惠平台和优惠券聚合网站需要从多个城市的几十家超市网站收集每周传单图片,但每家超市的页面结构不同、更新周期不同,人工采集慢、易错、难扩展。
业务背景:面向零售促销信息聚合场景,需要一个能自动拉取任务、抓取传单、校验促销日期、上传图片并回写状态的全自动管道,保证传单内容持续更新且一致。


点击空白处退出提示



立项原因:零售优惠平台和优惠券聚合网站需要从多个城市的几十家超市网站收集每周传单图片,但每家超市的页面结构不同、更新周期不同,人工采集慢、易错、难扩展。
业务背景:面向零售促销信息聚合场景,需要一个能自动拉取任务、抓取传单、校验促销日期、上传图片并回写状态的全自动管道,保证传单内容持续更新且一致。
功能模块包括:API 任务调度模块、日期校验模块、多站点解析模块、内存下载与 FTP 上传模块、状态回写模块。
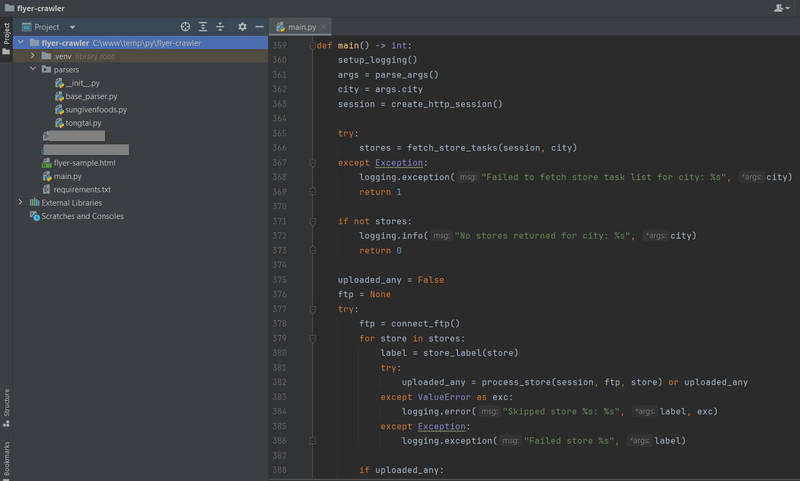
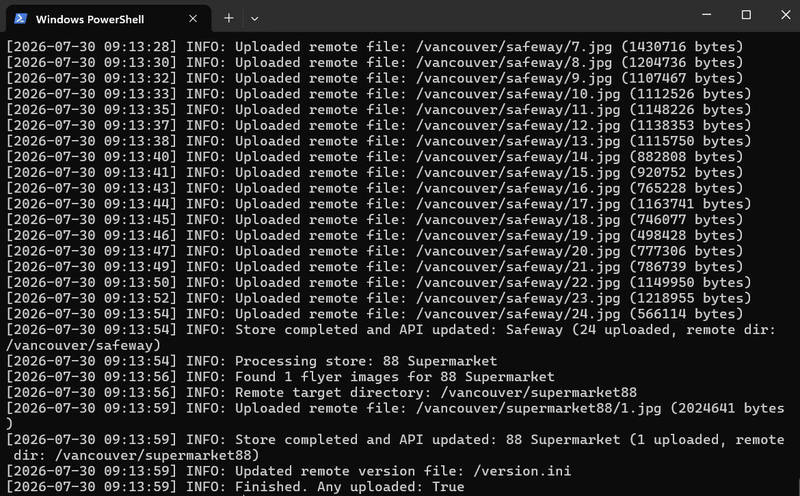
主要功能:API 任务调度模块从 WordPress REST API 拉取按城市分组的门店任务列表,每个门店独立处理,单个失败不影响整批;日期校验模块解析页面上的促销有效期,与数据库比对,只有检测到更新时才执行抓取;多站点解析模块采用策略模式,共享 BaseParser,按门店名动态导入专属解析器,支持 Elementor 画廊等非标准布局;内存下载与 FTP 上传模块将传单图片下载到内存,校验图片/PDF/AVIF 完整性后按城市/门店目录结构上传到 FTP;状态回写模块在成功后通过 API 更新数据库中的传单日期和有效期,并刷新远程 version.ini 缓存。
我负责该项目的整体设计与开发。技术栈:Python 3(核心逻辑)、requests + BeautifulSoup4 + cloudscraper(HTTP 抓取与反爬兼容)、Pillow(图片校验)、ftplib(FTP 上传)、WordPress Custom REST API(任务获取与状态回写)、importlib(动态解析器工厂)。
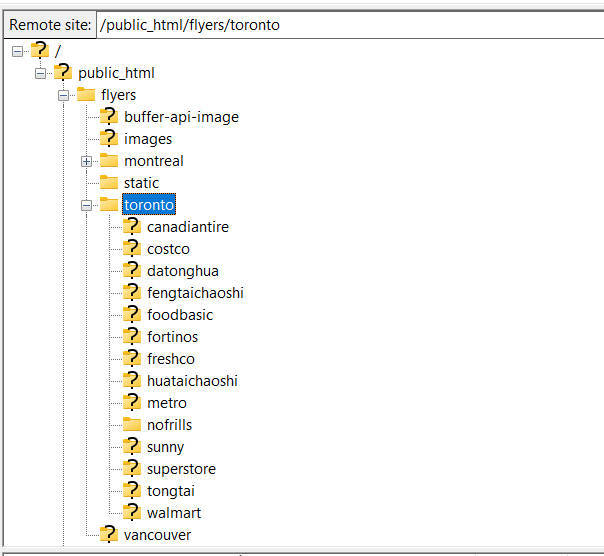
具体工作包括:设计基于 WordPress REST API 的任务调度流程;实现策略模式的多站点解析器架构,支持按门店名动态加载;编写日期校验逻辑,判断 EXECUTE / SKIP / BLOCK 三种状态;实现内存下载、图片完整性校验和 FTP 流式上传;设计按城市/门店的目录结构和递归目录创建;编写状态回写和 version.ini 刷新逻辑;配置控制台与文件双路日志,支持按城市运行的 CLI 入口。
难点在于:不同超市网站的页面结构差异很大,需要设计可插拔的解析器架构,让新增门店只需加一个文件;部分站点有 Cloudflare 反爬,需要设计兼容会话;促销日期格式不统一,需要健壮的解析和校验逻辑。亮点是策略模式 + 动态工厂的架构,加上按门店隔离的容错机制,让系统在几十个站点上稳定运行,且扩展成本极低。

评论