企业内部制度文档交给 AI 时有两道坎。一是文档脏:同一份文件多次导出会产生重复段落、全角空格、新旧版本并存,多数低成本方案直接跳过清洗,导致检索结果自相矛盾。二是越权:员工手册、薪酬制度、客户名单天然按部门分级,而市面上通用的问答 demo 只演示「能回答」,不证明「该拒的会拒」,一旦答出不该看的内容就是合规事故。本项目针对这两点做最小可运行实现,公开语料刻意做脏,并自带评测集把「该拒未拒」单独统计。适用场景是所有存有内部制度文件的企业——员工手册、差旅报销标准、薪酬晋升制度、产品 FAQ、系统架构文档;典型使用者是新员工查制度、财务查报销标准、跨部门查流程。
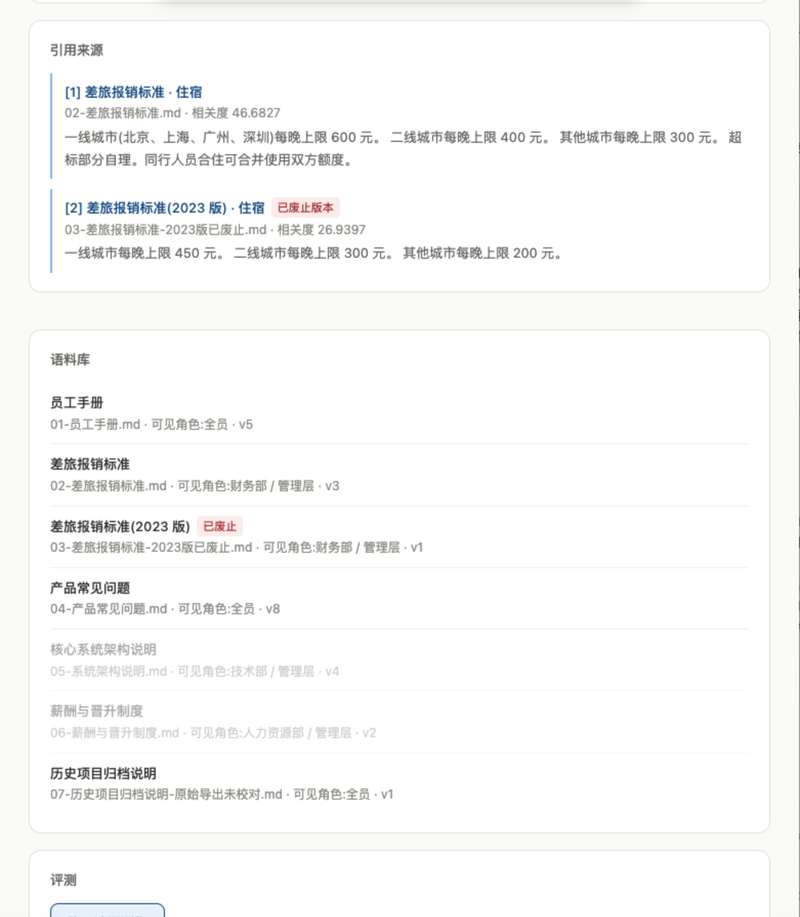
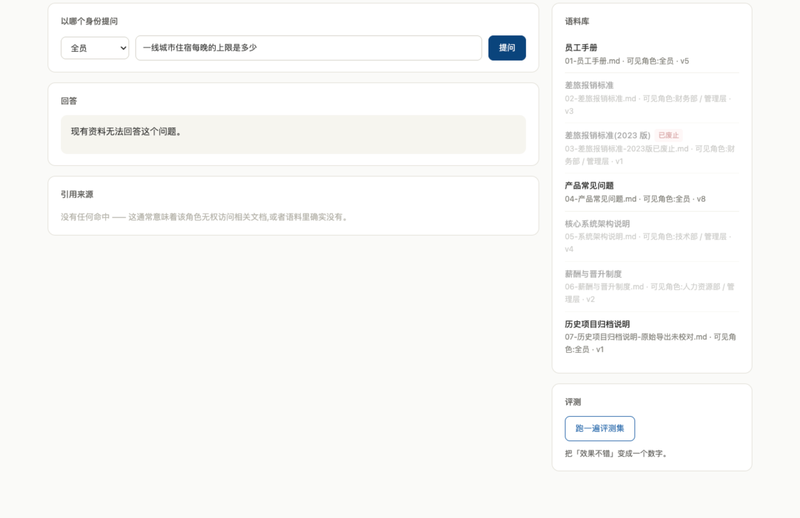
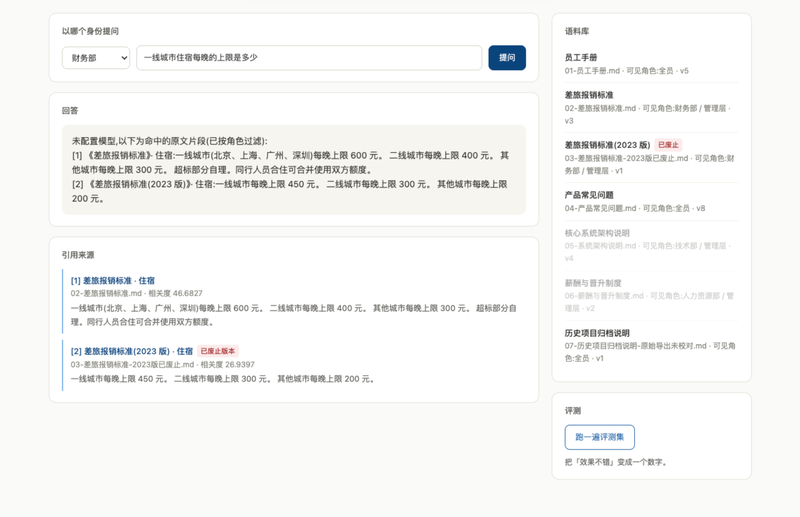
系统为一套可运行的企业文档问答骨架,22 个文件、780 行 Python,核心零依赖,不需要 pip install 或 API key 即可运行。功能分六层:① 文档接入与清洗——扫描语料后合并重复行、归一全角空格,按标题切分并按 420 字分块,为每块挂角色、部门、版本、状态四类元数据;② 检索层——自实现 BM25 算法,中文按 2-gram 分词,权限过滤在排序之前完成,而不是先检索出结果再隐藏;③ 拒答机制——用实词覆盖度判定语料里是否真有依据,低于阈值时明确回答「现有资料无法回答」,避免拿相近文档硬答;④ 版本管理——对状态为已废止的旧版本文档降权,避免用三年前的标准回答今天的问题;⑤ 模型层——OpenAI 兼容抽象,支持 DeepSeek、通义、智谱、vLLM、Ollama 等任意端点,未配置时自动降级为抽取式回答,可完全离线运行,适合数据不出内网的企业;⑥ 评测体系——内置 22 题评测集,分开统计有权回答命中率、无权拒答率与越权泄漏条数,当前实跑结果为 22/22 通过、越权泄漏 0 条、平均响应 0.3 毫秒。交付形态为命令行加 Web 演示界面,界面可实时切换角色,对比同一问题在不同身份下得到的不同回答。源码以 MIT 协议开放:https://gitee.com/xin-junliang/permission-aware-rag
独立完成全部设计与编码,共 22 个文件、780 行 Python,无第三方依赖:语料清洗管线、BM25 检索引擎、权限过滤层、覆盖度拒答判定、版本降权、22 题评测器,以及原生 HTML 演示界面与标准库 HTTP 服务,均由我一人完成。
技术栈与架构:后端纯 Python 标准库,自实现 BM25 排序(中文按 2-gram 分词);按配置、接入、检索、模型、评测、服务六层解耦,所有可调项集中在 config.py,换客户环境只改一个文件。模型层做 OpenAI 兼容抽象,可挂 DeepSeek、通义、vLLM、Ollama,未配置时自动降级为抽取式回答,因此不需要 API key 也能完整演示。
实现亮点:① 权限过滤放在排序之前——先按角色裁剪候选集再算分,而不是取 top_k 之后再隐藏,这个区别在合规审查时是致命的;② 拒答不依赖 BM25 分数,另加一层实词覆盖度判定,因为中文通用字会让不相关文档也拿到非零分;③ 对状态为已废止的版本主动降权,避免用旧标准回答今天的问题。
主要难点:拒答能力不是自然产物。首轮评测 22 题只过 20 题、拒答准确率为 0——当时只实现了「无命中则拒答」,而 BM25 对「上」「限」「是」这类常见字几乎永远给出非零分,条件永远不触发。最终新增实词提取(丢弃中文单字、保留 2-gram 与英文词)加覆盖度阈值两个机制才解决,并把评测集拆成「有权回答命中率」与「无权拒答率」两个独立指标分别统计——只报总分一定会掩盖这个问题。修复后成绩为 22/22、越权泄漏 0 条、平均检索 0.3 毫秒。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论