

某企业服务公司的内部文档分散在多个系统里——PDF、Word、Excel、在线文档页面都有,总量 3 万+。
员工找一份资料平均要花 10 分钟,而且传统搜索只会匹配关键词:搜「报销标准」能搜到,搜「出差花销怎么算」就搜不到了。靠人工整理索引在这个体量下不现实。


点击空白处退出提示



某企业服务公司的内部文档分散在多个系统里——PDF、Word、Excel、在线文档页面都有,总量 3 万+。
员工找一份资料平均要花 10 分钟,而且传统搜索只会匹配关键词:搜「报销标准」能搜到,搜「出差花销怎么算」就搜不到了。靠人工整理索引在这个体量下不现实。
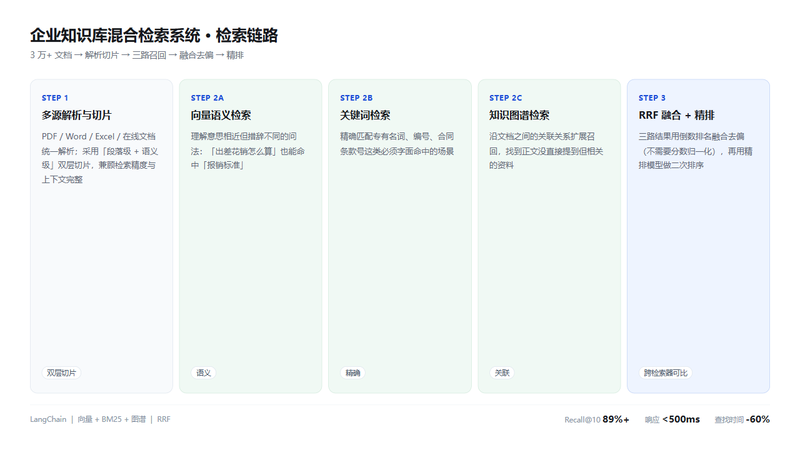
一、多源文档解析管道
支持 PDF、Word、Excel 等主流格式的统一解析,制定「段落级 + 语义级」两种粒度的切片策略,构建高质量索引。
二、三路混合召回
同时运行三路检索:向量语义检索(理解意思相近但措辞不同的问法)、关键词检索(精确匹配专有名词与编号)、知识图谱路径检索(找出文档之间的关联关系)。三路结果经 RRF(倒数排名融合)去偏后,再用精排模型做二次排序。
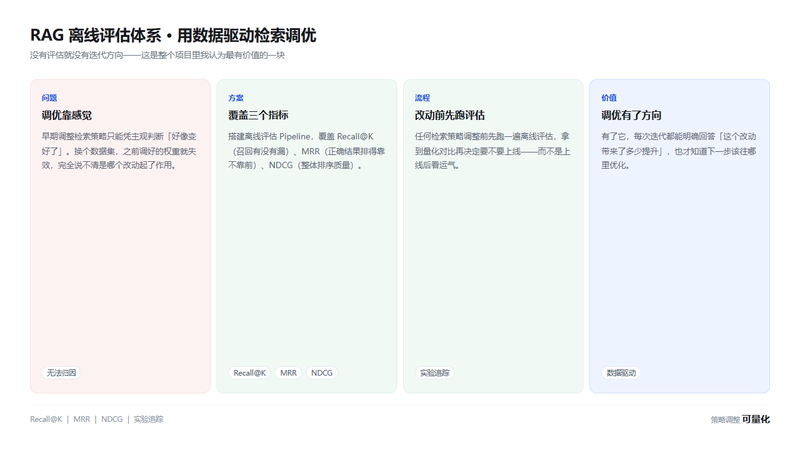
三、RAG 离线评估体系
搭建覆盖 Recall@K、MRR、NDCG 的评估 Pipeline。每次调整检索策略都先跑离线评估,用数据判断到底有没有变好,而不是凭感觉。
我负责检索链路的调优与工程落地,主要是三块:
1. 文档解析与切片策略
核心是切片粒度问题——切太粗检索不准,切太细会丢失上下文。最后采用「段落级 + 语义级」两层策略。
2. 三路召回 + 融合排序
向量、关键词、图谱三路同时召回,再用 RRF 融合。RRF 的好处是不需要对不同检索器的分数做归一化——不同检索器的分数分布差异极大,直接加权很难调。
3. 离线评估 Pipeline
这块我认为是整个项目最有价值的部分。没有评估就没有迭代方向,有了它,每次调优都能拿到量化的反馈。
技术栈:LangChain / FastAPI / 向量数据库 / 图数据库 / 嵌入模型 / 重排模型 / PostgreSQL / Docker / BM25 / RRF
踩过的三个坑:
· 切片粒度难定——反复试了几轮,从单一粒度改成两层策略。
· 融合权重靠拍脑袋——早期手工调权重,换个数据集就失效。改用 RRF 后只关心排名,跨检索器天然可比。
· 没有评估就没有方向——这是最大的教训,也是后来补上评估 Pipeline 的直接原因。

评论