随着企业规模扩大和组织结构日益复杂,人力资源管理正逐步由传统的经验驱动向数据驱动转型。人事大数据平台通过整合员工档案、招聘、考勤、绩效、薪酬、培训、晋升及离职等多源数据,构建统一的人力资源数据体系,并结合数据分析、指标监控和智能预测能力,对企业人员结构、人才流动、组织效能及用工风险进行全面洞察。管理者可以实时掌握各部门人员规模、年龄与职级分布、人才梯队、招聘完成率、员工流失率及人力成本等关键指标,及时发现人员流失异常、人才缺口和组织配置不合理等问题,为人才招聘、岗位调配、绩效优化和组织战略规划提供数据支撑,实现人力资源管理的数字化、智能化与精细化。
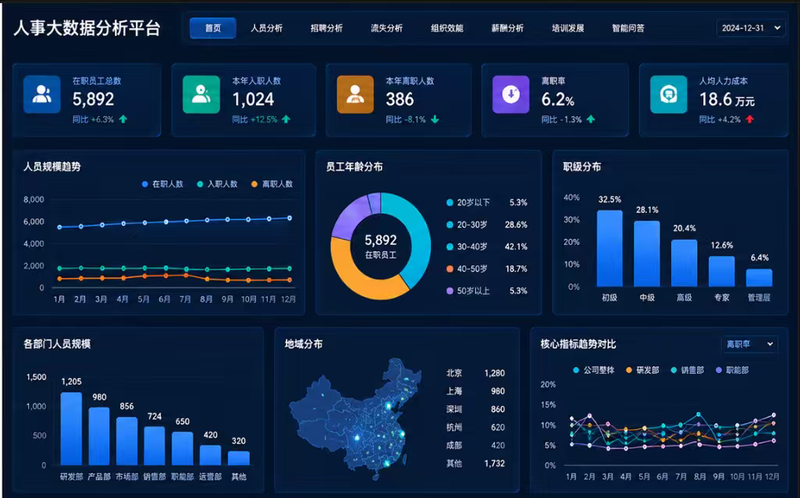
人事大数据平台围绕“数据整合、智能分析、辅助决策”构建核心能力,支持员工档案、招聘、考勤、绩效、薪酬、培训、晋升及离职等多维人事数据的统一接入与管理。平台可通过可视化看板实时展示人员规模、组织结构、年龄分布、职级分布、人才流动、人力成本等关键指标,并支持按部门、地区、岗位、职级等维度进行多层级钻取分析。同时结合员工流失预警、人才画像、招聘效果分析、组织效能评估等智能分析能力,帮助管理者快速发现人员配置异常与潜在用工风险,为招聘规划、人才盘点、人员调配及组织优化提供数据支撑。
### 项目实现
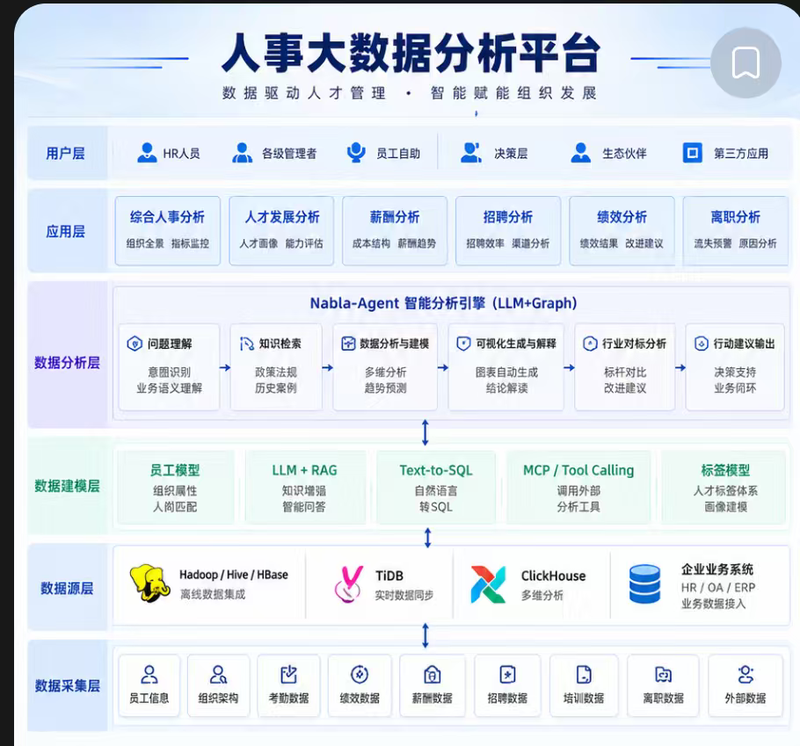
项目围绕企业人力资源数据分析与智能决策场景,搭建统一的人事大数据分析平台。首先对员工档案、入离职、组织架构、考勤、绩效、薪酬等多源数据进行统一接入与治理,通过数据仓库完成数据清洗、标准化和指标口径统一;在此基础上构建人事主题数据模型和指标体系,实现员工规模、入职人数、离职人数、期末在职人数、平均在职人数、离职率等核心指标计算。
平台进一步引入智能 Agent 能力,通过自然语言交互完成指标查询、数据分析、异常定位和任务编排。用户可直接提出“某部门近半年离职率为什么上升”等业务问题,系统自动进行意图识别、任务拆解、数据查询、指标计算和结果总结,并通过可视化看板展示分析结果,为人力资源管理和组织决策提供数据支持。
### 技术栈
后端主要采用 **Python + FastAPI** 构建业务及智能分析服务,使用 **LangGraph** 实现多 Agent 工作流编排,并结合 **MCP / Tool Calling** 将数据查询、数据质量检测及任务调度等能力封装为标准化工具。
数据层采用 **Hive / Paimon** 进行数据存储与管理,通过 **Trino** 提供统一 SQL 查询能力,并基于语义层对人事指标、维度及业务口径进行统一封装。任务调度采用 **Airflow**,实现数据同步、指标计算及周期任务的自动化运行。
智能分析部分结合 **大语言模型 + RAG + Text-to-SQL**,支持自然语言理解、指标识别、数据检索和分析结果生成,并通过 Checkpointer 保存会话状态,实现多轮分析任务的上下文恢复和连续执行。
### 项目亮点
**1. 统一人事指标语义层**
针对不同业务系统中指标定义不一致的问题,将入职人数、离职人数、平均在职人数、期末在职人数、离职率等核心指标进行统一建模,同时支持部门、地区、职级、用工类型等多维分析,减少重复 SQL 开发并保证不同分析场景下指标口径一致。
**2. Multi-Agent 智能分析架构**
采用 Planner、Router 及多个专业 Agent 的协作架构,根据用户问题自动进行任务拆解和能力路由,由不同 Agent 分别完成数据查询、数据质量分析、任务调度及结果汇总,相比单一 Agent 提升了复杂分析任务的可扩展性和稳定性。
**3. 自然语言驱动数据分析**
用户无需编写 SQL,即可通过自然语言提出业务问题,系统自动完成指标识别、维度解析、SQL 生成、数据查询及结果解释,使非技术人员也能够进行复杂的人事数据分析。
**4. 数据分析与数据治理联动**
不仅提供数据查询能力,还能够结合数据质量检测发现空值、重复数据、异常波动及指标口径问题,在分析结果异常时进一步定位到底层数据,形成“查询—分析—诊断”的完整链路。
**5. 多轮任务状态恢复**
基于 LangGraph Checkpointer 保存 conversation_id 对应的工作状态,在复杂分析任务中支持中断恢复和上下文继承,使用户可以围绕同一个业务问题持续追问和深入分析。
### 项目难点
**1. 多源人事数据口径统一**
不同业务系统对于入职、离职、在职人数等指标的计算规则存在差异,例如跨部门调动、短期离职后重新入职、员工经历合并等情况都会影响指标结果,因此需要建立统一的数据模型及业务规则,保证指标计算准确。
**2. 自然语言到业务指标的准确映射**
用户提问方式具有较强的不确定性,例如“人员流失情况”“员工流动率”“离职趋势”可能对应相同或不同指标,需要结合语义层完成指标、维度、时间范围及筛选条件识别,降低大模型直接生成 SQL 带来的错误率。
**3. Multi-Agent 协作与任务路由**
复杂问题可能同时涉及数据查询、数据质量检查和任务调度,需要判断任务应该串行还是并行执行,同时避免 Agent 之间重复调用或循环调用,因此需要设计清晰的 Planner、Router 和状态流转机制。
**4. 大数据查询性能优化**
人事历史数据涉及员工生命周期及多维度统计,复杂查询容易产生大范围扫描和多表关联,因此通过 Trino、分区设计、预聚合指标及语义层缓存等方式优化查询效率,在保证灵活分析能力的同时降低响应延迟。
**5. 大模型结果可信度控制**
大模型容易产生指标解释错误或 SQL 幻觉,因此系统不让模型直接决定最终数据结果,而是将指标定义、数据查询和计算逻辑交由确定性的数据服务执行,大模型主要负责意图理解、任务编排和结果解释,从架构层面提升分析结果的可靠性。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!
下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态




评论