

企业客户需要大模型推理服务,但单台 GPU 节点部署大模型性能不足、成本高,多模型并存时手工管理繁琐,且原有调用方依赖 OpenAI 接口格式。本方案基于双 Spark GPU 服务器节点部署 vLLM 推理集群,提供统一 OpenAI 兼容接口,实现模型自动调度与成本优化。适用于有大模型 API 服务、多模型管理与降本增效需求的企业。

点击空白处退出提示
企业客户需要大模型推理服务,但单台 GPU 节点部署大模型性能不足、成本高,多模型并存时手工管理繁琐,且原有调用方依赖 OpenAI 接口格式。本方案基于双 Spark GPU 服务器节点部署 vLLM 推理集群,提供统一 OpenAI 兼容接口,实现模型自动调度与成本优化。适用于有大模型 API 服务、多模型管理与降本增效需求的企业。
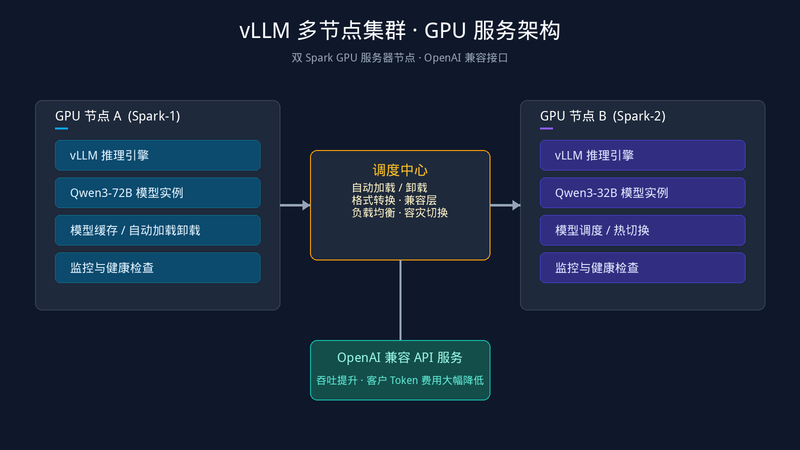
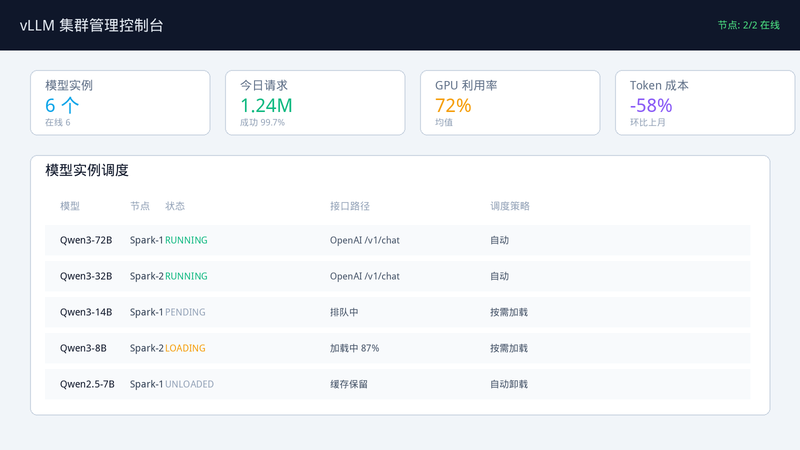
系统核心能力:1、双节点集群:Spark GPU 服务器双节点部署 vLLM,支撑百亿参数模型并发推理;2、模型调度:模型自动加载/卸载、按需加载与热切换,空闲资源自动释放;3、OpenAI 兼容接口:统一 /v1/chat 等标准接口,调用方零改造接入;4、格式兼容层:多模型权重格式转换与兼容性处理;5、负载均衡:请求自动分发至最优节点,故障自动容灾切换;6、监控告警:GPU 利用率、请求吞吐、成功率实时监控。
我作为总负责人完成集群方案设计、部署与调优。vLLM 推理引擎部署于双 Spark GPU 节点,调度中心负责模型生命周期管理与负载均衡;实现模型格式转换与兼容层,对外暴露 OpenAI 兼容 API,原有业务无感切换。部署 Docker + 系统服务保障稳定性,监控面板实时观测资源与请求状况。成果:服务吞吐显著提升,客户 Token 费用大幅降低,运维从手工切换改为全自动调度。

评论