

企业内部制度、产品手册、FAQ 散落在 PDF 和 Word 里,员工找答案靠翻文件、问同事,新人上手慢,HR 和客服每天重复回答相同问题。本项目让员工用自然语言提问,系统从企业自己的文档中检索依据并生成回答,同时附上出处,适用于企业内部知识管理、客服知识库、医院/学校制度问答等场景。


点击空白处退出提示



企业内部制度、产品手册、FAQ 散落在 PDF 和 Word 里,员工找答案靠翻文件、问同事,新人上手慢,HR 和客服每天重复回答相同问题。本项目让员工用自然语言提问,系统从企业自己的文档中检索依据并生成回答,同时附上出处,适用于企业内部知识管理、客服知识库、医院/学校制度问答等场景。
1. 文档管理:支持上传 PDF、Word、Markdown,自动解析、清洗、分块并建立索引;启动时可批量导入。
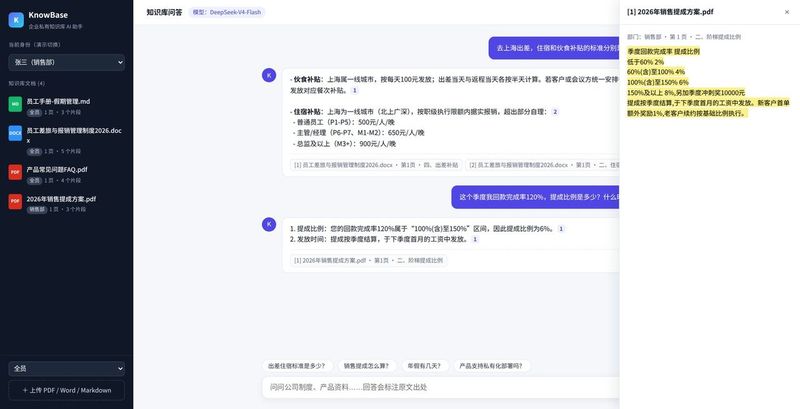
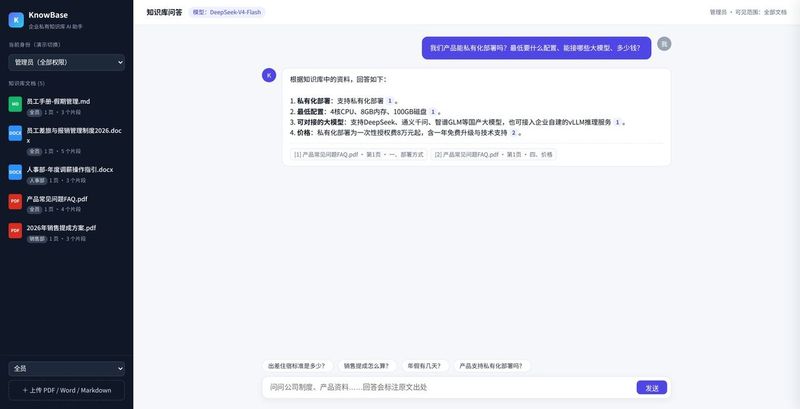
2. 智能问答:自然语言提问,检索相关段落后由大模型生成回答,流式逐字输出,回答下方列出引用的原文片段和文件名,可追溯。
3. 部门权限:按账号所属部门过滤可检索的文档,销售部看不到人事部的薪酬文件,管理员可查看全部。
4. 模型可配置:兼容 OpenAI 协议的任意大模型服务(DeepSeek、通义千问、硅基流动等),可自动选择可用模型。
5. 部署:提供 Docker、docker-compose 和 Nginx 反向代理配置,一条命令即可部署。
独立完成需求设计、后端、前端、部署全部工作。
技术栈:Python + FastAPI 后端,SSE 流式输出,前端原生 HTML/JS,Docker + Nginx 部署。
亮点与难点:
1. 中文检索采用 BM25(中文二元分词,无需词典),可选叠加向量检索,两路结果用 RRF 融合排序,兼顾关键词精确匹配和语义相似。
2. PDF 提取文字常出现康熙部首等"长得一样但编码不同"的字符导致检索不到,做了 NFKC 归一化和部首字修正表,并合并 PDF 断行。
3. 权限在检索阶段就过滤,避免越权内容进入大模型上下文。
4. Nginx 反代下关闭缓冲(X-Accel-Buffering),保证流式输出不卡顿。

评论