

面向海量非结构化文本数据开展离线批量统计。依托Hadoop的HDFS分布式文件存储能力完成原始数据持久化,借助Spark分布式计算引擎实现文本分词、词频聚合统计。可应用于日志解析、文档词频挖掘等业务场景,本项目用于大数据分布式计算课程实训,验证分布式存储与离线统计的完整工作链路。


点击空白处退出提示



面向海量非结构化文本数据开展离线批量统计。依托Hadoop的HDFS分布式文件存储能力完成原始数据持久化,借助Spark分布式计算引擎实现文本分词、词频聚合统计。可应用于日志解析、文档词频挖掘等业务场景,本项目用于大数据分布式计算课程实训,验证分布式存储与离线统计的完整工作链路。
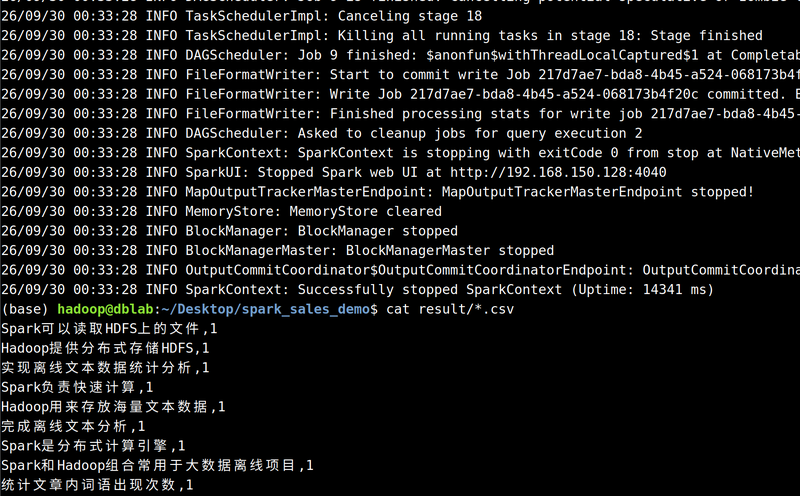
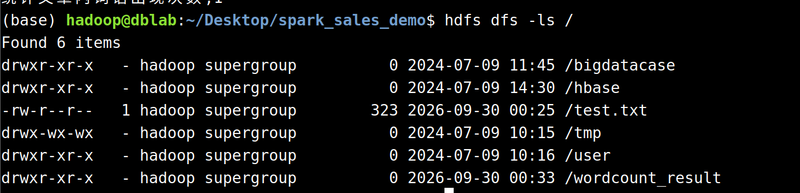
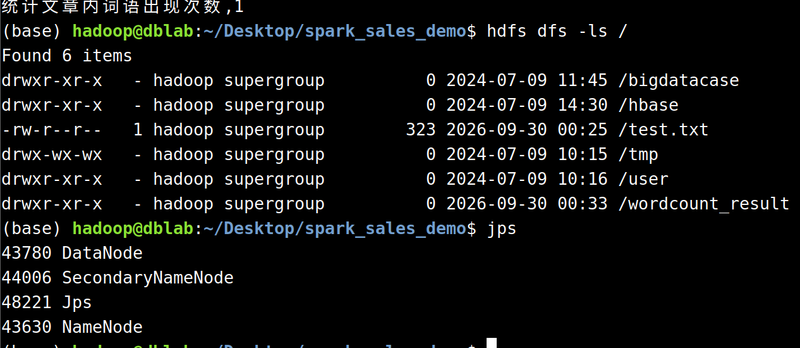
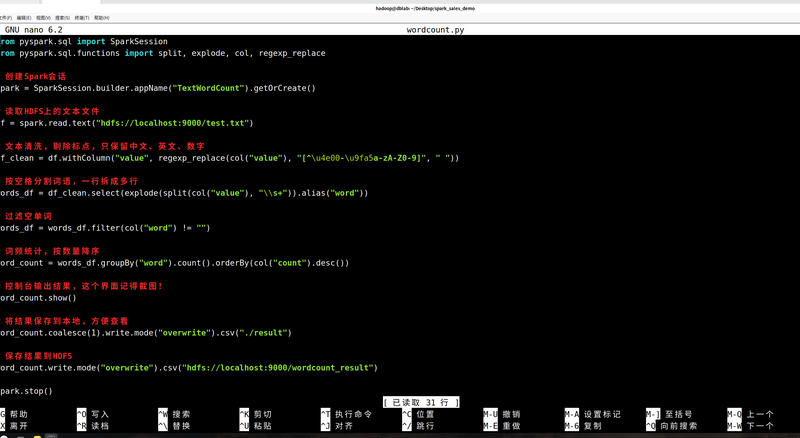
本项目搭建Hadoop分布式存储环境,搭配Spark框架实现离线文本词频统计。原始文本文件上传至HDFS分布式文件系统,使用PySpark编写业务逻辑,完成文本分割、单词提取、分组聚合,最终输出词频排序结果,并将统计结果回写保存至分布式存储。
项目完整复现“分布式存储+离线计算”经典大数据架构。在实操过程中,完成虚拟机环境部署、Hadoop服务启停、Spark会话配置、数据读写调试,解决分布式环境下文件路径、资源调度等实际问题,加深对MapReduce、Spark惰性求值、HDFS读写机制的理解。项目可扩展至服务器运行日志、海量文档集的批量分析。
本项目从环境部署到代码实现、调试运行均由本人独立完成,主要负责集群环境配置、依赖问题排查、离线统计逻辑开发与项目整体测试落地。
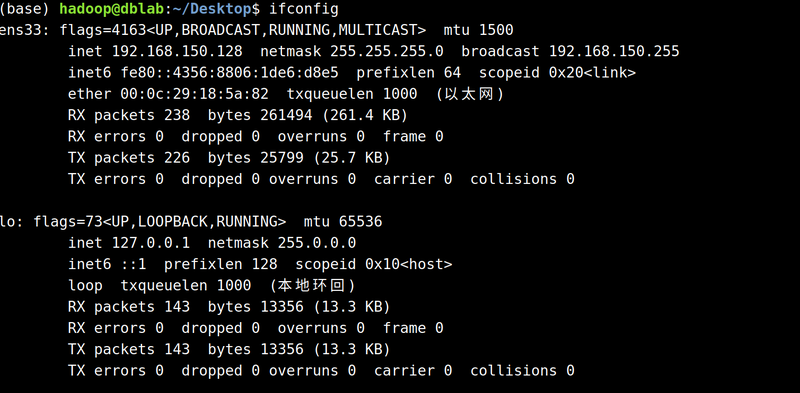
项目整体采用Hadoop HDFS分布式存储 + Spark离线计算的主流大数据架构,基于Python的PySpark模块开展开发工作。利用HDFS承担分布式文件存储与数据管理工作,依托Spark内存计算引擎完成批量数据处理,在虚拟机伪分布式环境下搭建出完整的小型大数据离线分析链路,复刻了企业基础离线数据处理流程。
项目实现亮点在于,全程基于真实分布式集群环境运行,区别于普通单机代码实验,完整实现了数据上传、读取计算、结果输出的闭环流程;同时手动解决环境兼容问题,实操性强,代码逻辑简洁通用,可灵活拓展至日志统计、文本挖掘等各类离线数据分析场景。
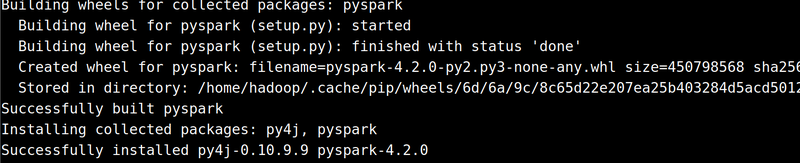
实现过程中的主要难点为:Spark运行依赖特定Java环境,初始环境缺失导致程序启动异常,需手动配置安装依赖完成修复;分布式HDFS文件路径与本地路径规则差异较大,调试阶段需反复核对路径保证数据正常读取;同时Spark惰性计算机制容易造成任务执行异常,通过梳理算子执行逻辑、规范代码顺序,最终稳定实现文本离线词频统计功能;Spark与JDK版本存在严格的兼容关系。高版本Spark编译依赖JDK17,一开始使用JDK8运行程序,出现类版本不匹配异常,后续更换JDK17环境解决版本兼容问题。Linux系统会自动后台执行软件更新任务,会占用包管理器锁,此时无法执行apt安装命令,等待后台更新释放资源后,才能继续安装依赖。

评论