

针对自媒体运营团队、舆情监测人员和市场分析师在选题阶段缺乏实时热点数据支撑的问题,本系统通过自动化采集今日头条热榜数据,输出结构化报告,帮助用户快速锁定高热度话题。
典型业务场景包括:每日早间选题会、突发事件舆情追踪、竞品内容对标分析、垂直领域热点挖掘。


点击空白处退出提示



针对自媒体运营团队、舆情监测人员和市场分析师在选题阶段缺乏实时热点数据支撑的问题,本系统通过自动化采集今日头条热榜数据,输出结构化报告,帮助用户快速锁定高热度话题。
典型业务场景包括:每日早间选题会、突发事件舆情追踪、竞品内容对标分析、垂直领域热点挖掘。
本系统核心功能包括:
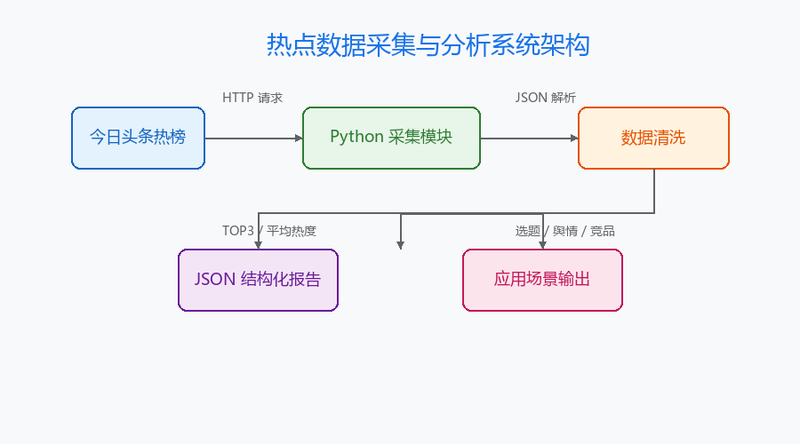
1. 自动采集今日头条热榜 TOP 20 数据,覆盖社会、科技、财经、娱乐等多个分类;
2. 数据解析与清洗,提取排名、标题、热度值、分类、URL 等字段;
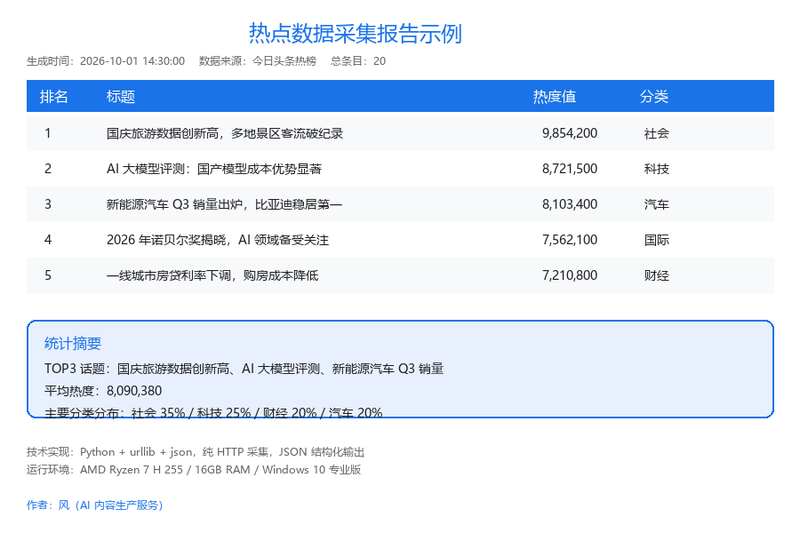
3. 生成 JSON 格式结构化报告,包含 TOP3 摘要与平均热度统计;
4. 支持按时间戳命名输出文件,便于历史数据归档;
5. 内置 HTTPS 代理兼容处理,适应企业内网和中间人代理环境。
系统纯 Python 实现,无需浏览器依赖,可在 Windows、Linux、macOS 上稳定运行。
我负责了本系统的全流程实现。技术栈采用 Python 3.x + urllib + json + ssl 标准库,不引入重型依赖。
实现步骤:
1. 通过 urllib 构造 HTTP 请求,模拟浏览器 User-Agent 访问今日头条热榜接口;
2. 针对本机 HTTPS 中间人代理环境,关闭 TLS 主机名校验,保证请求可达;
3. 使用 json 模块解析返回数据,按 rank/title/hot_score/category/url 结构重组;
4. 通过 pathlib 管理输出路径,按生成时间自动命名报告文件;
5. 编写异常处理逻辑,网络超时或接口变更时返回空列表并打印错误。
实现中的难点是接口反爬与代理 TLS 校验,解决方案是增加请求头与可配置 SSL 上下文。

评论