

笔记与资料积累到 3600 多份后,检索只能靠翻文件夹,旧内容沉淀下来就变成死数据;同时又不愿把内部资料上传到云端做检索,希望有一套能离线运行、答案可核对的私有知识库。这类需求普遍存在于有产品手册、FAQ、制度文档的中小团队与个人知识管理场景。


点击空白处退出提示



笔记与资料积累到 3600 多份后,检索只能靠翻文件夹,旧内容沉淀下来就变成死数据;同时又不愿把内部资料上传到云端做检索,希望有一套能离线运行、答案可核对的私有知识库。这类需求普遍存在于有产品手册、FAQ、制度文档的中小团队与个人知识管理场景。
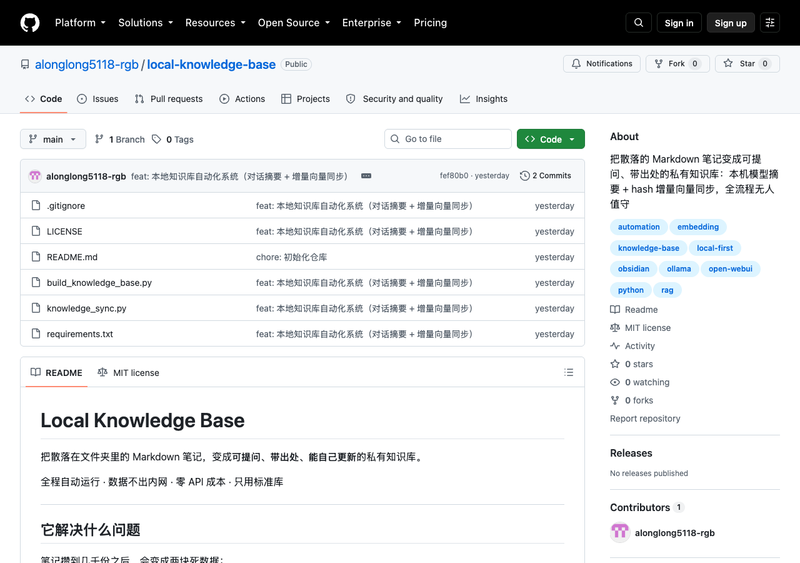
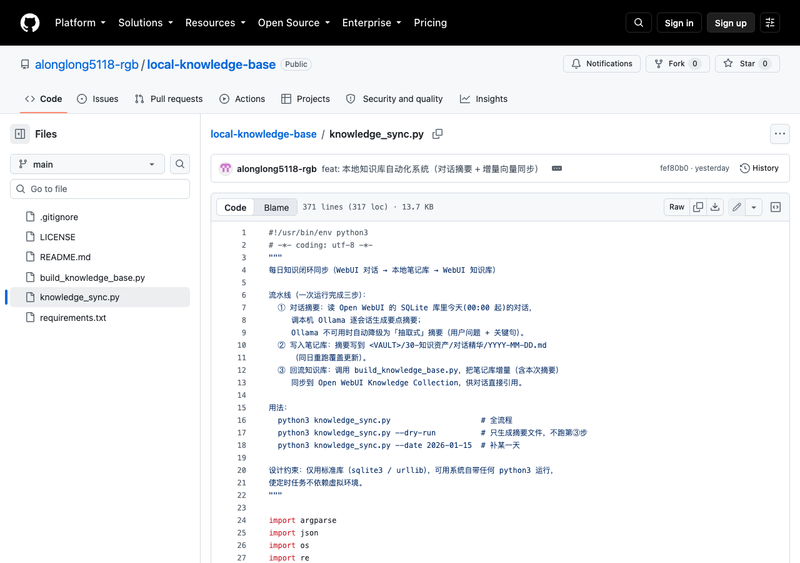
把散落的 Markdown 笔记与文档,变成可提问、带出处、能自己更新的私有知识库。功能模块:① 分层存储——按"原始记录 / 项目档案 / 长期记忆"三层组织资料并按主题归类;② 每日自动同步——定时读取新增内容、调用本地大模型生成摘要、写回知识库并回流向量库,全程无人值守;③ 向量检索问答——提问返回答案并标注来源出处,可逐条人工核对;④ 增量更新——按内容 hash 比对,仅处理发生变化的文件;⑤ 容错降级——本地模型不可用时自动降级为抽取式摘要,任务不中断。
我独立负责全链路设计与开发。技术栈:Python 3 标准库为主(sqlite3、urllib)、本地大模型(Ollama)、本地 Embedding 向量检索、launchd 定时调度、文件系统批处理。实现亮点:一是三级降级容错,模型调用失败不影响主流程;二是按内容 hash 的增量更新,避免全量重跑;三是源库只读打开,避免锁库导致写入失败。结果:连续自动运行 3 个月、人工干预 0 次,管理 3600 多份文件,API 成本为 0,可完全断网运行。

评论