

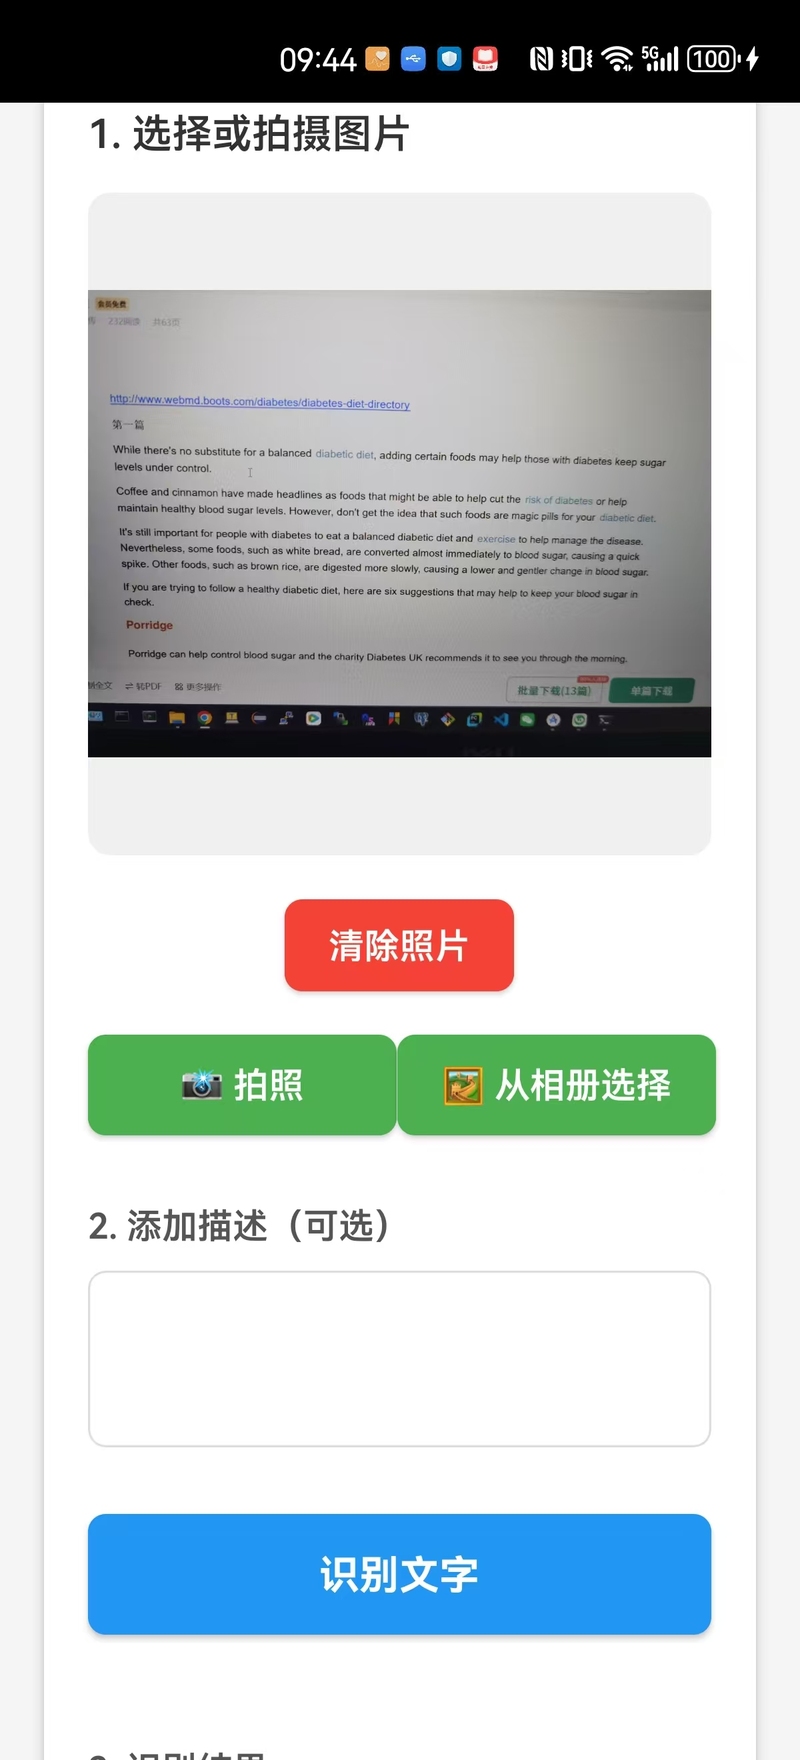
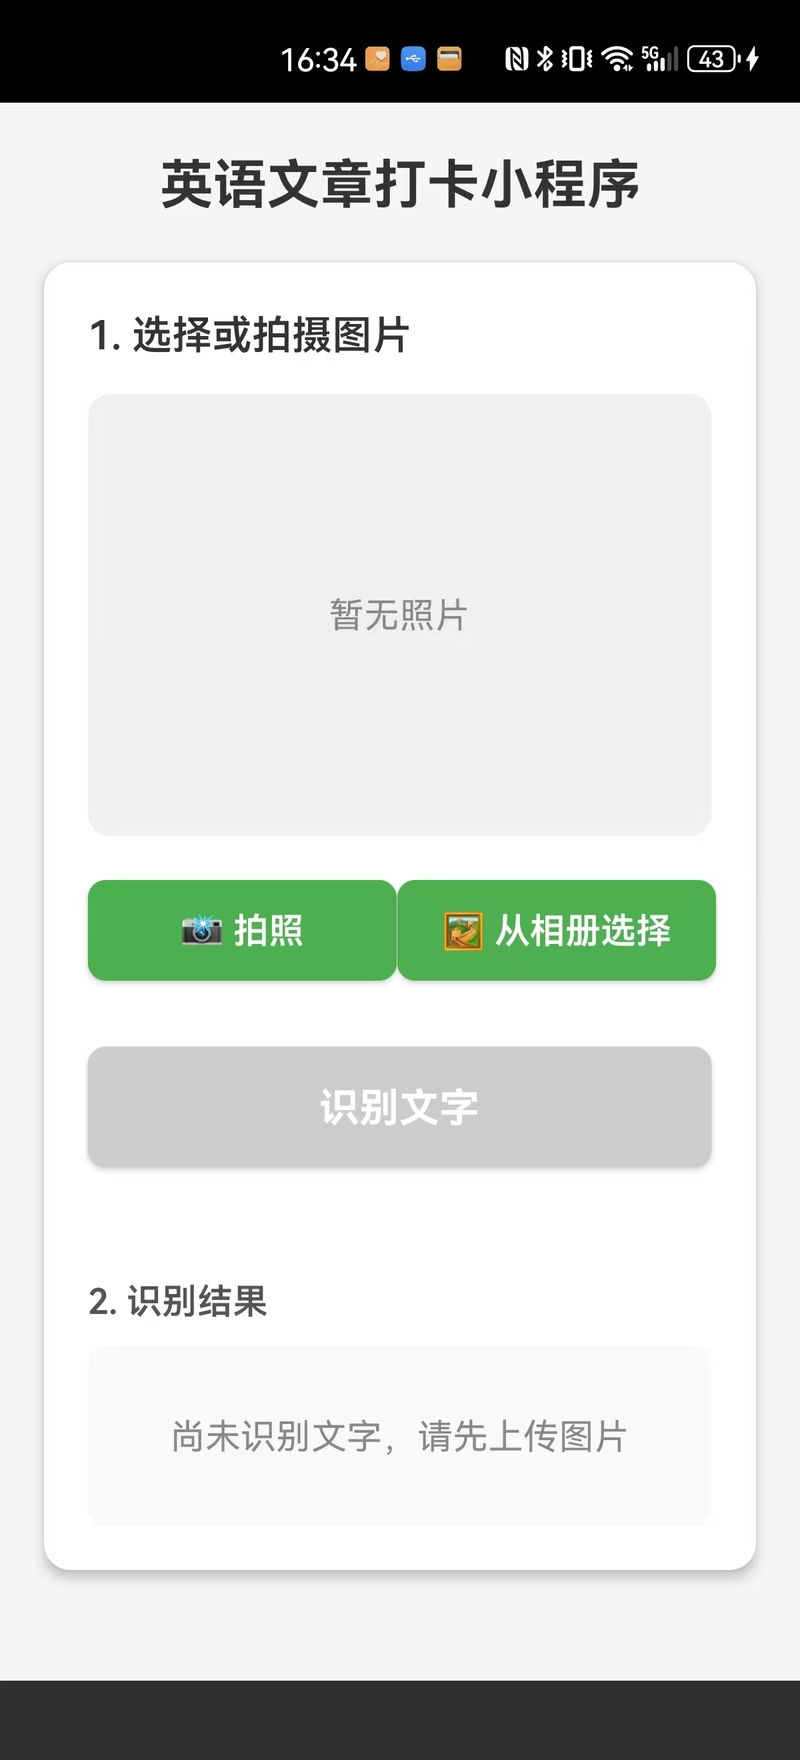
能够让英语学习者自主的扫描书籍,进行上传,形成语音文件,进行数据存储和自主学习。

点击空白处退出提示
能够让英语学习者自主的扫描书籍,进行上传,形成语音文件,进行数据存储和自主学习。
OCR项目实现了一个repository层,用于管理从图片提取的文字和生成的语音文件的持久化存储。所有文件都保存到.env文件中设定的TTS_OUTPUT_DIR目录
自己的兴趣项目,背后使用的LLM进行OCR和STT/TTS的转化。
1. ArticleRepository类 (app/repositories/article_repository.py)
这是一个数据仓库层,负责文章的持久化存储,主要功能包括:
保存文章信息:将OCR提取的文字保存为文本文件,并在articles.txt中记录元数据
CSV格式存储:使用CSV格式记录文章信息,包含以下字段:
uuid: 文章唯一标识符
title: 文章标题
text_file: 文本文件名
audio_file: 音频文件名
created_at: 创建时间戳
文章管理:提供获取、删除文章的功能
自动目录创建:确保TTS_OUTPUT_DIR目录和articles.txt文件存在
2. OCR服务集成 (app/services/ocr_service.py)
修改了OCR服务,集成repository层

评论