

自研示例面向业务表格整理与公开商品目录采集场景,解决重复记录、格式不一致、异常数据被误合并以及采集结果难以复核的问题。通过可执行 Python 脚本、来源追溯与对账检查,将原始输入整理为可用的 CSV 和异常清单。联系记录为模拟数据,商品数据来自公开练习站,属于演示项目。


点击空白处退出提示



自研示例面向业务表格整理与公开商品目录采集场景,解决重复记录、格式不一致、异常数据被误合并以及采集结果难以复核的问题。通过可执行 Python 脚本、来源追溯与对账检查,将原始输入整理为可用的 CSV 和异常清单。联系记录为模拟数据,商品数据来自公开练习站,属于演示项目。
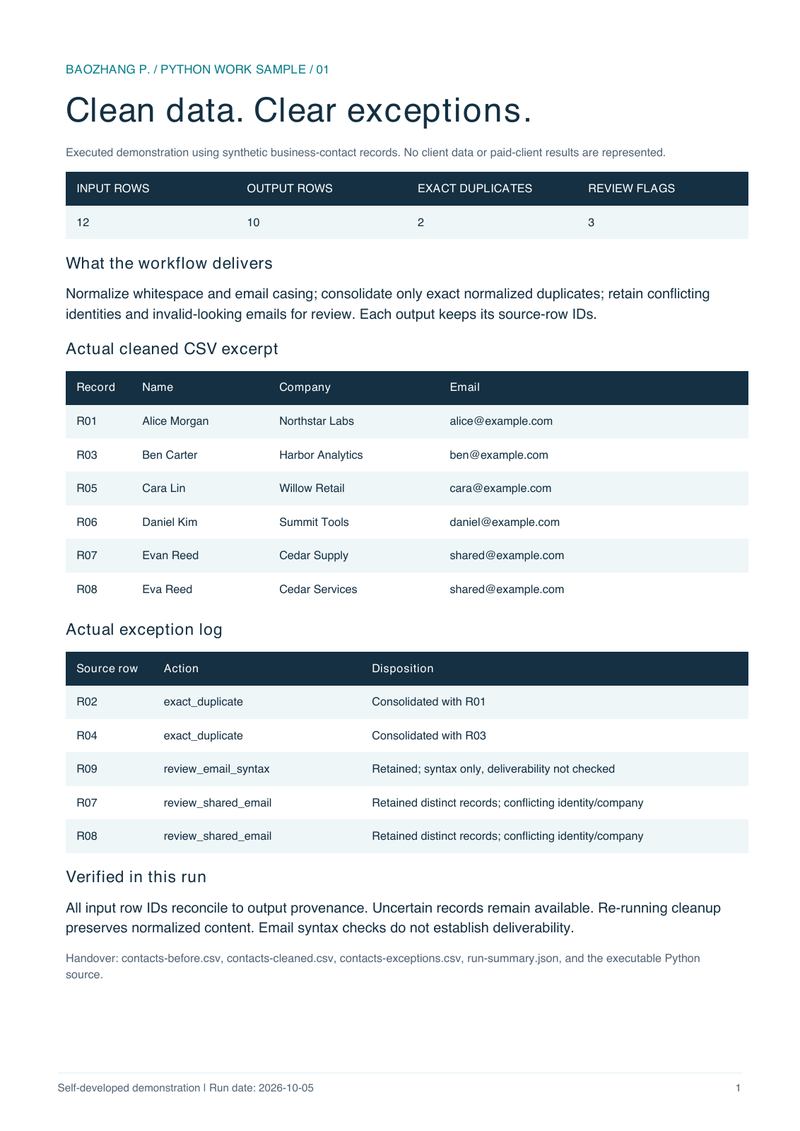
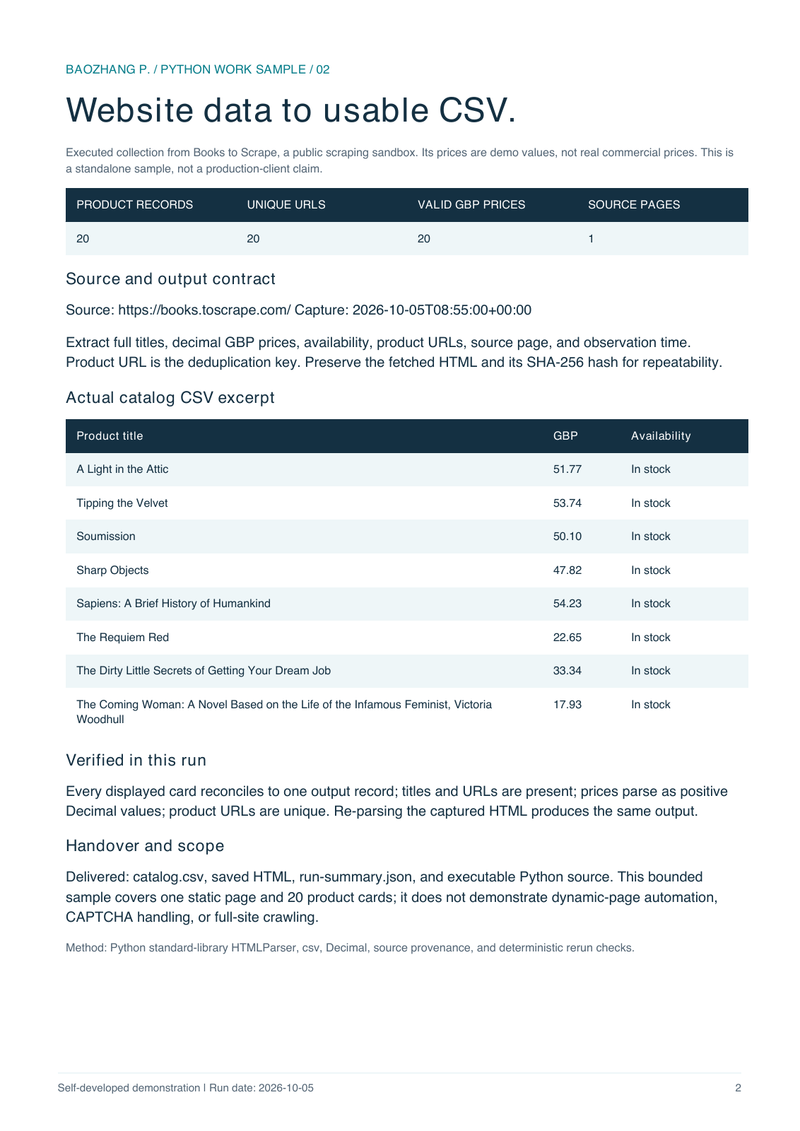
清洗模块规范空白字符和邮箱大小写,仅合并完全一致的标准化记录,保留身份冲突及格式异常供复核;实测将十二行模拟记录整理为十条,合并两条精确重复,并保留三个复核标记。采集模块从 Books to Scrape 单页提取二十条商品,保留标题、英镑价格、库存、商品链接、来源页和采集时间。输出包括清洗前后 CSV、异常清单、商品目录、保存的 HTML 与运行摘要。来源对账和重复解析检查已通过,两张配图展示实际演示输出。练习站价格为演示值,结果仅覆盖该单页样例。
我负责样例范围、输出字段和验收规则,使用 OpenAI Codex 进行 AI 辅助开发,审阅脚本并核对结果。采用 Python 标准库 HTMLParser、csv、Decimal 与 SHA-256 记录,实现可重复解析、输入输出行数对账、精确去重及异常保留。已有运行记录核实了两组样例结果;作品使用模拟联系数据和公开练习站数据。

评论