1.立项原因:传统数字人视频制作成本高、周期长,且跨语种视频的翻译与配音(本地化)存在极高壁垒。本项目旨在解决音视频内容生产中“多模态生成门槛高”的核心痛点。
2. 产品价值:系统集成 SadTalker、GPT-SoVITS 等前沿开源模型,采用微服务架构(FastAPI + Redis + PM2)。提供从“说话人分离、语音克隆、文本配音”到“数字人视频合成、视频翻译”的一站式解决方案。大幅降低短视频、企业培训、跨境出海等场景的内容生产成本,实现高效、批量的 AIGC 音视频自动化生产。
本项目是一个深度融合了大语言模型与多模态 AIGC 技术的综合性 AI Studio 创作平台。系统采用前端 React + 后端微服务架构,主要包含五大核心业务模块:
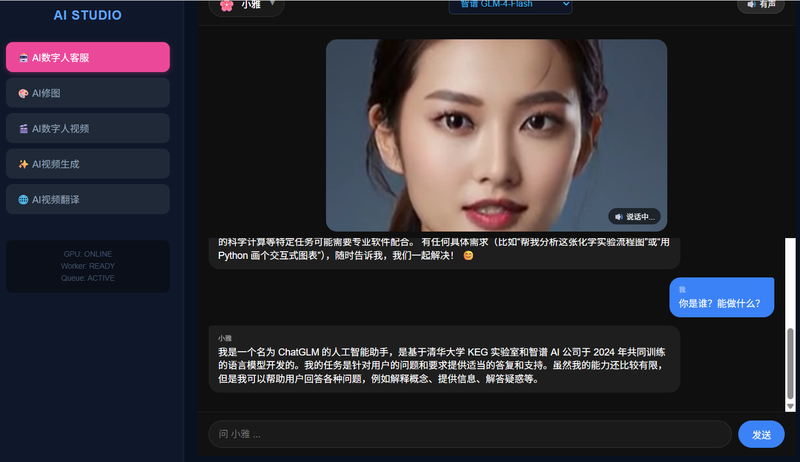
1.AI数字人客服:集成智谱 GLM 大语言模型(支持流式对话),结合数字人驱动技术,提供具备真实表情与拟真语音的智能客服交互体验。
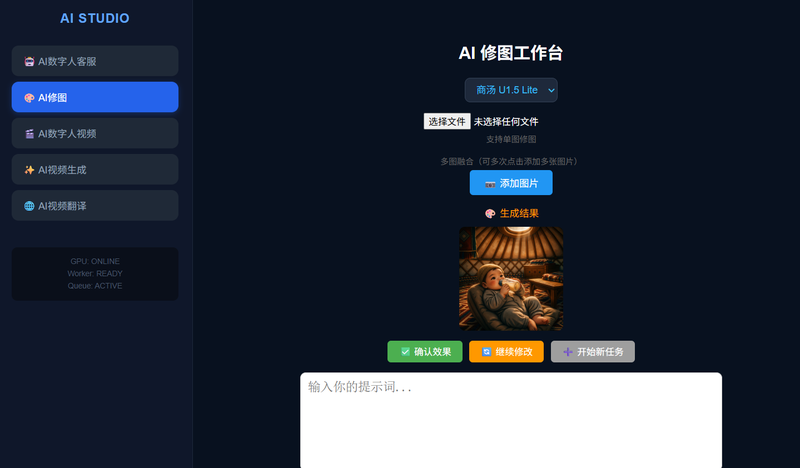
2.AI修图/图像处理:基于深度学习模型(如 GFPGAN、Stable Diffusion 等),提供老照片修复、面部增强、AI 图像生成与重绘等图像处理能力。
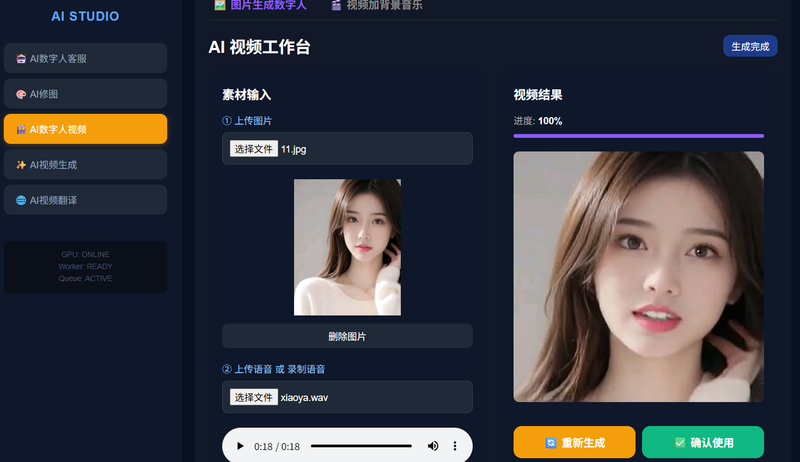
3.AI数字人视频:通过 SadTalker 等算法,输入单张照片与文本/音频,即可自动生成高保真、唇形完美同步的数字人播报视频。
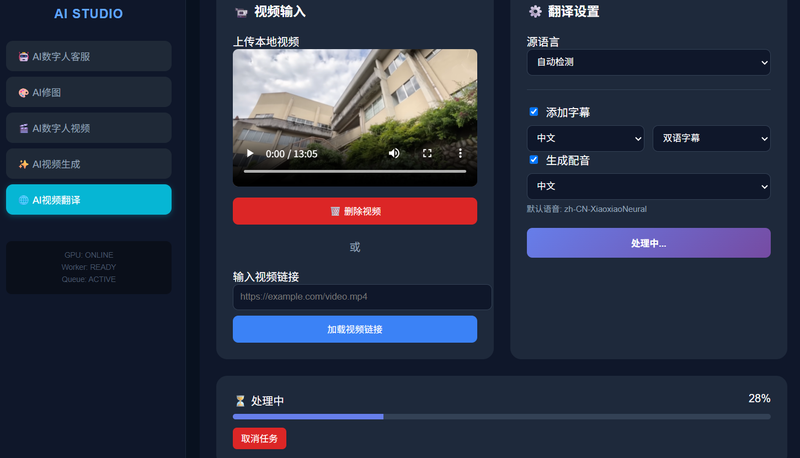
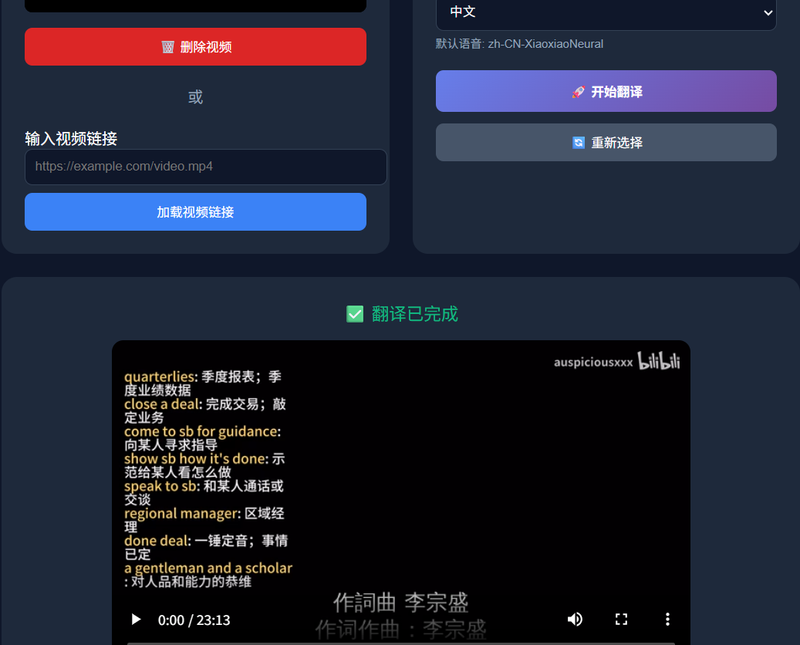
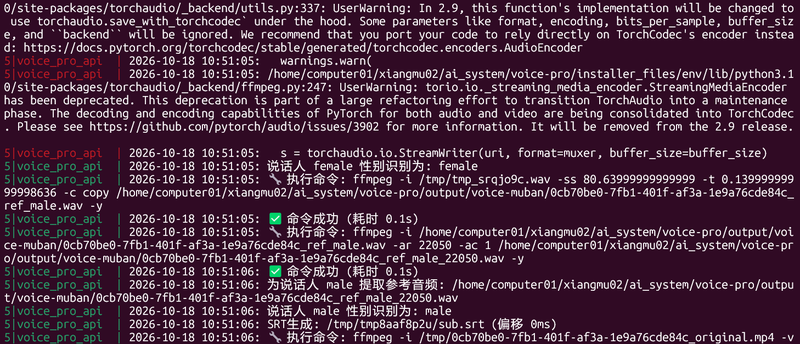
4.AI视频生成与翻译:集成了 Voice-Pro 和 DiariZen 等音视频处理管线,支持说话人分离、多语种字幕翻译、AI 语音克隆配音(GPT-SoVITS/XTTS)以及视频本地化的一站式生成。
5.任务调度与状态监控:提供直观的底层架构监控看板,实时展示 GPU 运行状态、Worker 节点就绪状态及 Redis 任务队列活跃度,保障异步任务的稳定流转。
【我的工作】:作为全栈/架构核心开发者,我独立负责了从底层 AI 模型部署、微服务架构设计、后端 API 开发到前端 React 界面联调的全流程。重点解决了多模型并发下的显存管理问题以及复杂任务队列的调度分发。
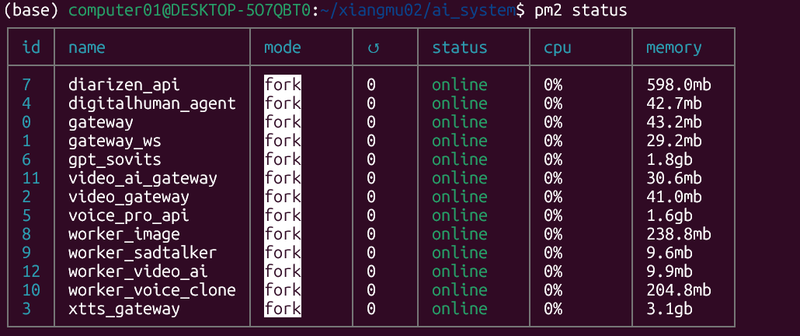
【技术栈与架构】:前端采用 React 构建;后端基于 Python FastAPI 框架,使用 PM2 托管了 13 个微服务进程(包含 HTTP 网关、WS 网关、业务 API 及异步 Worker)。系统引入 Redis 作为消息队列处理耗时音视频任务,并深度集成了智谱 GLM 大模型与多套开源 AIGC 模型。
【亮点与难点】:
异构环境隔离:由于 SadTalker、GPT-SoVITS 等模型依赖冲突严重,我利用 Conda 创建了多个独立的虚拟环境(如 xtts_env_py310),通过 PM2 的动态 interpreter 配置实现了不同 Python 环境服务的统一拉起与管理。
GPU资源与异步队列调度:面对音视频生成高耗时的痛点,设计了 Gateway(网关) -> Redis Queue(队列) -> Worker(消费者) 架构。前端通过 WebSocket 连接网关获取实时进度,后端 Worker 节点独立消费任务,结合 CUDA_VISIBLE_DEVICES 进行算力隔离,有效防止了 OOM 崩溃。
大模型与流式交互:在 AI 数字人客服中,接入了智谱 GLM 模型,并通过 WebSocket 实现了大模型流式文本回复,同时联动 TTS 引擎与数字人渲染,打造了低延迟的智能交互体验。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论