

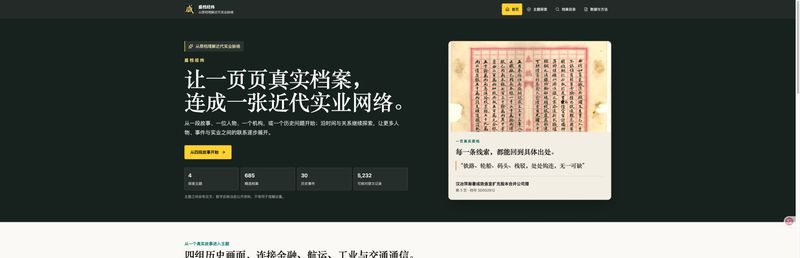
面向图书馆、数字人文研究及历史学习场景,解决扫描档案难检索、古文阅读门槛高、人物机构关系分散、AI 回答缺少可核对出处等问题。基于上海图书馆开放数据,围绕近代金融、航运、工业与交通通信四条主题,将原始档案整理为可搜索、可对照、可追溯来源的研究材料,帮助用户从故事、人物、机构或具体问题进入档案研究。


点击空白处退出提示



面向图书馆、数字人文研究及历史学习场景,解决扫描档案难检索、古文阅读门槛高、人物机构关系分散、AI 回答缺少可核对出处等问题。基于上海图书馆开放数据,围绕近代金融、航运、工业与交通通信四条主题,将原始档案整理为可搜索、可对照、可追溯来源的研究材料,帮助用户从故事、人物、机构或具体问题进入档案研究。
1、档案目录与检索:支持按主题浏览档案、查看封面、摘要及来源信息。
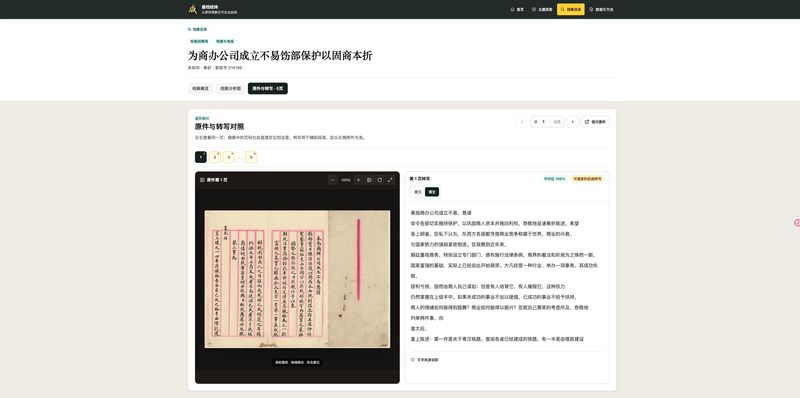
2、原件与文字对照:提供分页原图、机器转写和现代译文,在可靠对位时联动显示文字对应的图像区域。
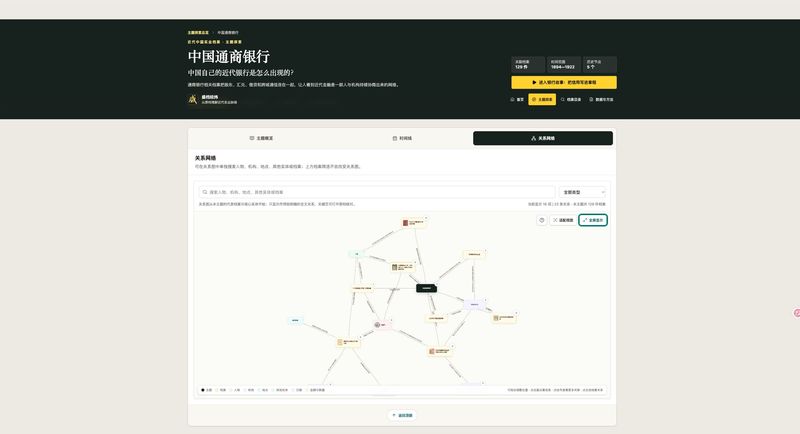
3、档案分析与探索:生成带来源页码的摘要和档案分析图,结合时间线、人物机构关系网络与主题故事展示历史线索。
4、AI 档案问答:采用关键词与向量混合检索,支持流式回答、停止生成及参考材料查看,保留档号、页码和原文短引供用户回查。
5、内容修订与版本管理:保存文本修改历史、差异和恢复记录,按依赖关系更新全文、摘要与检索索引。机器生成内容披露来源和状态,辅助用户核查。
负责产品方案、数据处理、前后端开发及部署。前端采用 React、TypeScript,后端采用 Python、FastAPI,使用 SQLite 管理档案与版本数据,通过 Docker、Nginx 部署。
实现多模态 OCR、跨页文本合成、实体抽取、向量索引与 RAG 检索问答;将回答和分析结果关联至档号、页码与原文短引,支持回到原件核对。工程上通过内容指纹缓存、后台异步任务、图片按需缩放缓存及派生数据依赖管理,减少重复处理并保持展示内容与来源版本一致。完成从档案采集、AI 处理、知识检索到交互式可视化展示的全流程。

评论