

本项目基于公开医疗数据集Pima。真实医疗数据普遍存在缺失值、样本类别不平衡等典型痛点。传统机器学习模型常为黑盒,单纯AUC指标不足以完整评估模型,现代临床预测建模需要额外评估校准度与决策收益。本项目完整复现一套前沿临床预测模型分析与可解释性分析流程。


点击空白处退出提示



本项目基于公开医疗数据集Pima。真实医疗数据普遍存在缺失值、样本类别不平衡等典型痛点。传统机器学习模型常为黑盒,单纯AUC指标不足以完整评估模型,现代临床预测建模需要额外评估校准度与决策收益。本项目完整复现一套前沿临床预测模型分析与可解释性分析流程。
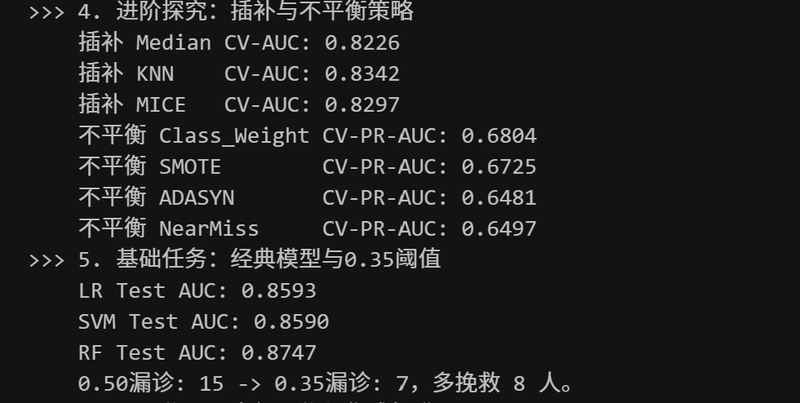
1. 数据预处理:医疗数据集清洗,对比MICE/KNN多种缺失值插补方案,使用SMOTE/类别权重处理样本不平衡问题。
2. 分类阈值寻优:不再固定0.5默认阈值,根据任务需求(如降低漏诊率)动态调整分类阈值,权衡灵敏度与特异度。
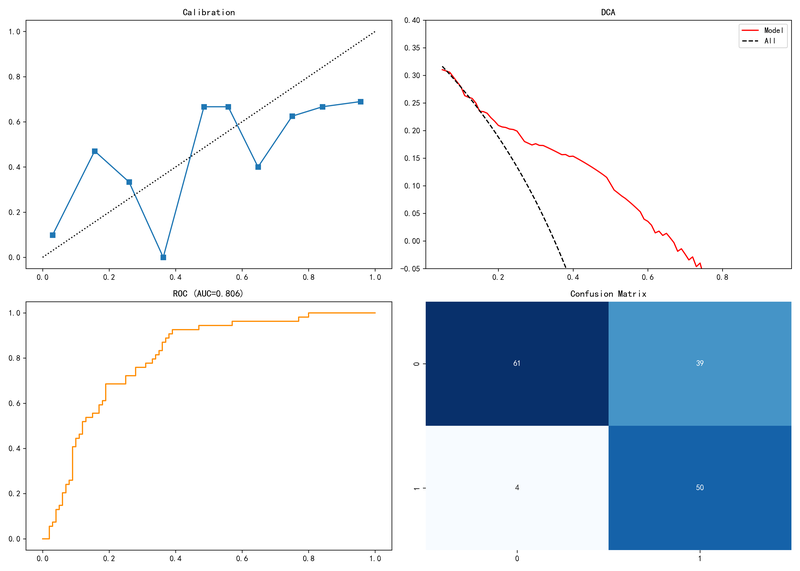
3. 模型多维评估:绘制ROC曲线、校准曲线(Calibration)、DCA决策曲线,从多个维度评估模型净收益。
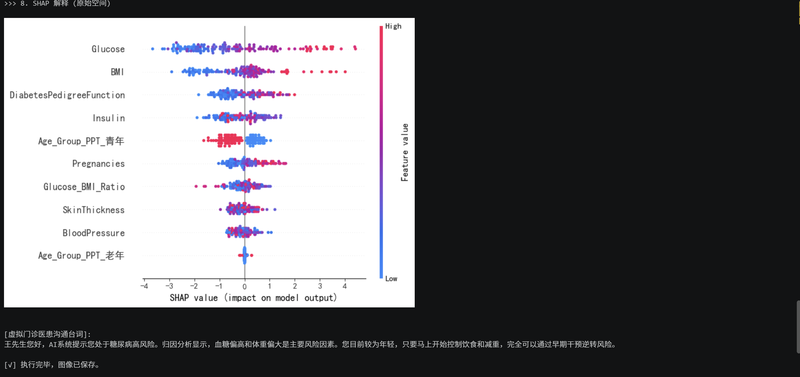
4. 模型可解释分析:采用SHAP做特征归因,分析各特征对预测结果的贡献,输出可视化图表。
交付内容:完整Python代码、高清可视化图片、训练模型文件(.pkl)、指标结果文档,可用于数据分析、建模报告、科研辅助分析。
技术栈:Python / Scikit-learn / XGBoost / SHAP / Pandas
1. 规避数据泄露:使用Pipeline流水线,插补、标准化操作仅在训练集拟合,严格防止验证集信息泄露。
2. 模型集成与概率校准:使用Voting集成学习+Sigmoid概率校准,在测试集上评估模型性能,外部盲测集灵敏度达92.59%。
3. 全套可视化分析:包含ROC、DCA、校准曲线、SHAP蜂群图等图表,可直接用于数据分析报告或科研辅助。

评论