本项目面向高校及中学数字化教学、智慧课堂与课后复习整理场景。针对学生与教师在课堂拍摄场景中遇到的痛点:课堂照片普遍存在斜拍透视形变、讲台及桌椅等复杂背景噪声多、黑板板书与PPT屏幕同帧混杂、手写板书笔迹与光照不均等问题,传统直接整图OCR极易出现识别区域混乱、文本顺序颠倒与乱码。
系统构建了端到端的自动化视觉笔记生成流水线:从原始课堂拍摄图像输入,全自动完成黑板/PPT多边形区域定位与分割、透视矫正与差异化图像增强、多区域文字检测识别,再到基于几何与版面逻辑的文本恢复,最终一键导出分章节、结构化的Markdown/TXT笔记,大幅降低课后数字化整理与资料归档成本。
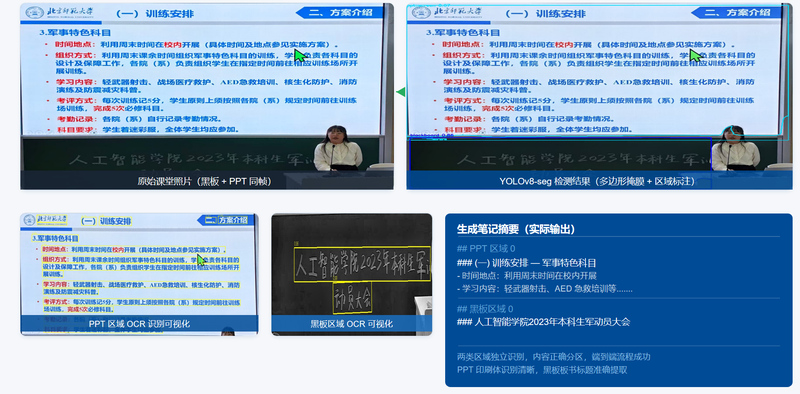
1. 教学区域智能检测与分割:基于YOLOv8-seg实例分割算法,精准定位并分离画面中的黑板(blackboard)与PPT投影屏(ppt_screen),有效剔除教室背景杂物与人物干扰。
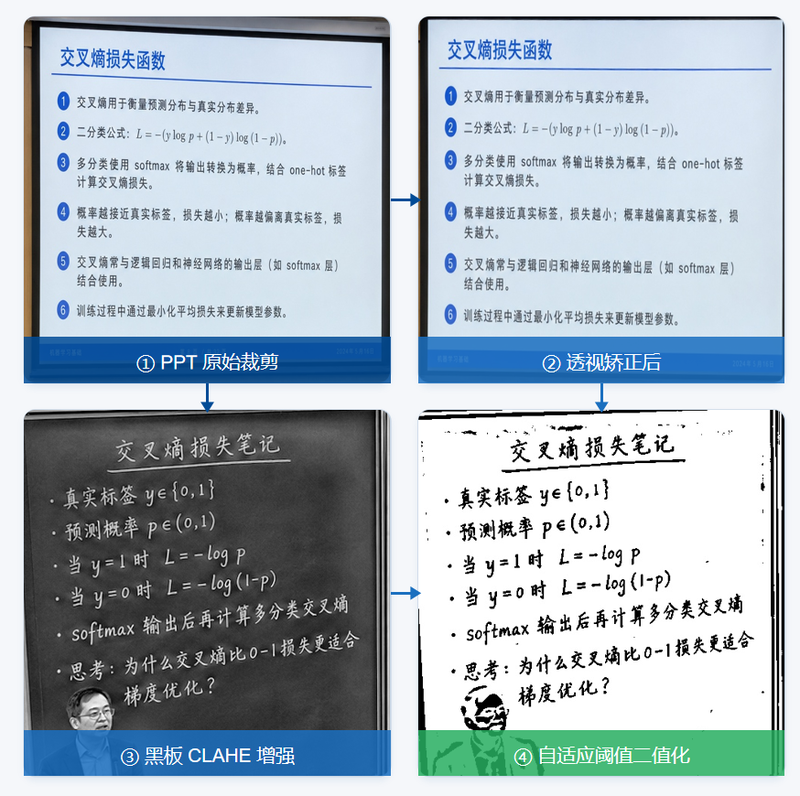
2. 自适应透视拉正与图像增强:通过多边形凸包与approxPolyDP多边形拟合提取四边形角点,利用透视变换将倾斜拍摄区域拉正为标准正面矩形;针对黑板采用CLAHE+双边滤波+自适应阈值提升手写对比度,针对PPT采用温和对比度增强抑制噪点。
3. 鲁棒OCR文字识别:深度封装PaddleOCR引擎,自适应兼容2.x/3.x数据结构,并设置置信度过滤阈值,避免无效噪声与乱码混入笔记。
4. 结构化阅读顺序恢复:采用纵向cy中心点动态行分组、水平中位数动态多列拆分检测、行内x1坐标排序等算法,完整恢复复杂课堂板书与双栏排版阅读逻辑。
5. 结构化笔记一键生成与导出:智能识别标题层级、列表符号与数字编号,黑板与PPT区域分节独立排版,自动输出高可用性的Markdown与TXT笔记文件。
6. 轻量Web与CLI双端运行:提供无第三方框架依赖(纯Python标准库)的本地轻量Web交互界面及支持调试的模块化命令行脚本,完整保留中间可视化图像证据链。
1. 模型训练与微调:基于yolov8n-seg预训练权重在自采标注的课堂数据集(覆盖多视角/光照/板书)上进行迁移学习,mAP50(Box)与mAP50(Mask)均达0.935,精确率达0.946,实现对教学区域的高精度多边形边界掩膜提取。
2. 几何校正与差异化预处理:提取分割掩膜外围凸包并拟合为四边形,计算透视变换矩阵完成正面矩形形变校正(warpPerspective);根据区域类型自适应路由——黑板区域经CLAHE(clipLimit=3)+双边滤波增强手写可见度,PPT区域温和处理,保留warped、enhanced、binary三类图像供调试。
3. OCR识别与规范化:接入PaddleOCR进行文字检测与识别,编写适配层统一dict/list格式并结构化为统一的OCRTextBox(含坐标、文本、置信度),过滤置信度低于0.6的候选框。
4. 版面分析与文本编排:计算中位行高×1.5作为动态行聚类阈值消除字号差异影响;基于横向空隙中位数判定多栏分列边界;最后按阅读流组织Markdown语法树,自动输出多级标题与列表格式。
5. 系统服务与工程落地:Web端基于Python内置http.server实现免环境依赖的轻量化服务,支持模型权重内存常驻与显存复用;同时提供分阶段CLI脚本(process_regions/process_ocr/process_notes)支持工业级批量处理与评估。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论