

已上线 wovenlab.cn
面向个人研究者的科研工作台,把文献阅读、实验数据、AI 助手与论文写作放在同一张「网」里:以项目为主线,文献喂给数据、数据支撑论文、AI 串联全程。


点击空白处退出提示



已上线 wovenlab.cn
面向个人研究者的科研工作台,把文献阅读、实验数据、AI 助手与论文写作放在同一张「网」里:以项目为主线,文献喂给数据、数据支撑论文、AI 串联全程。
AI 研究助手:接入 DeepSeek 大模型,多轮对话 + 工具调用循环,可操作文献与实验数据
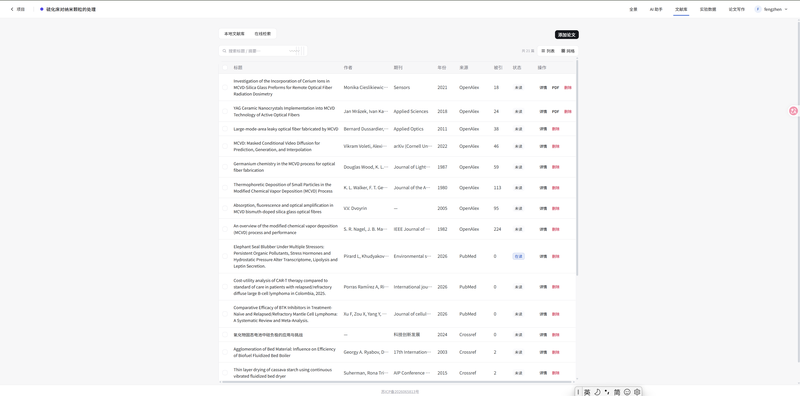
文献库:PDF 解析入库,基于 pgvector 的语义向量检索
实验数据:CSV/Excel 导入,pandas 统计分析与可视化
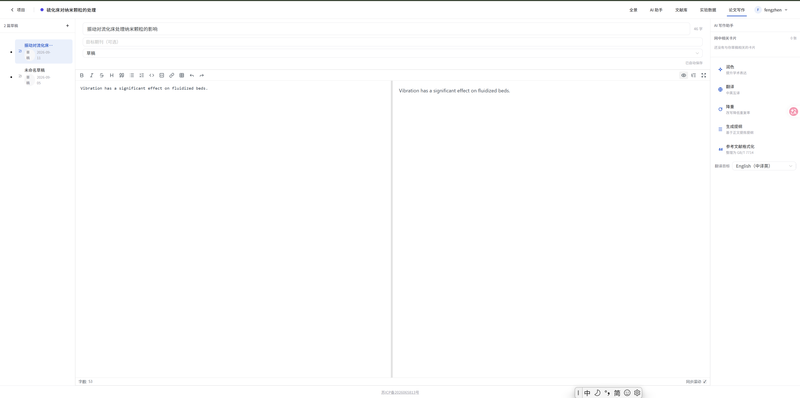
论文写作:Markdown 编辑器,与文献/数据联动
技能系统:支持从 GitHub 一键安装扩展技能
技术栈
前端:Vue 3 + TypeScript + Vite + Pinia + Naive UI + Tailwind CSS 4
后端:Django 5 + Django REST Framework + PostgreSQL/pgvector + httpx
AI:DeepSeek 兼容大模型接口,流式对话 + 工具调用
运维:腾讯云 / nginx / gunicorn / systemd,HTTPS
我的作用(全栈独立开发)
产品与设计:独立完成功能规划、交互设计与「蓝图极简」视觉体系,品牌手册与 Logo 均为手绘定稿
前端开发:全部页面、组件与状态管理,TypeScript 严格类型检查
后端开发:REST API 设计、LLM 工具调用循环、CSV/Excel/PDF 数据导入解析
数据库:PostgreSQL 数据建模与 pgvector 向量检索
部署运维:服务器环境搭建、HTTPS 配置、安全加固与日常运维
技术亮点
自研 LLM 工具调用循环:httpx 直连大模型接口(不依赖 SDK),实现流式输出与多轮工具执行——AI 可直接检索文献、查询并统计实验数据,而非仅停留在对话层面
基于 pgvector 的文献语义检索:PDF 解析入库 → 向量化 → 相似度检索,按语义而非关键词找文献
外部数据健壮性管线:对 CSV/Excel 导入的空值与异常类型做统一归一化清洗,杜绝脏数据写库与接口渲染崩溃
多租户数据隔离:全局按所有者过滤的权限模型,用户间数据完全隔离
可扩展技能系统(含安全设计):支持从 GitHub 一键安装技能扩展,带 manifest 能力声明、安装体积校验、网络访问授权白名单与撤销机制
工程质量:前端 vue-tsc 严格类型 + 后端 pytest 测试覆盖,开发/生产配置分层(SQLite / PostgreSQL)


评论