

面向短视频创作者、动漫/影视二创团队、课程与访谈内容生产者:收藏和保存的视频越来越多,但逐条看片、找镜头、记时间码、整理可复用方法仍高度依赖人工,转述结论也容易脱离原始证据。项目将视频转化为可检索、可追溯的结构化知识,覆盖内容理解、镜头拆解、长视频定位和素材归档,重点解决“看过却找不回、拆过却不可复现”的效率与可信度问题。


点击空白处退出提示



面向短视频创作者、动漫/影视二创团队、课程与访谈内容生产者:收藏和保存的视频越来越多,但逐条看片、找镜头、记时间码、整理可复用方法仍高度依赖人工,转述结论也容易脱离原始证据。项目将视频转化为可检索、可追溯的结构化知识,覆盖内容理解、镜头拆解、长视频定位和素材归档,重点解决“看过却找不回、拆过却不可复现”的效率与可信度问题。
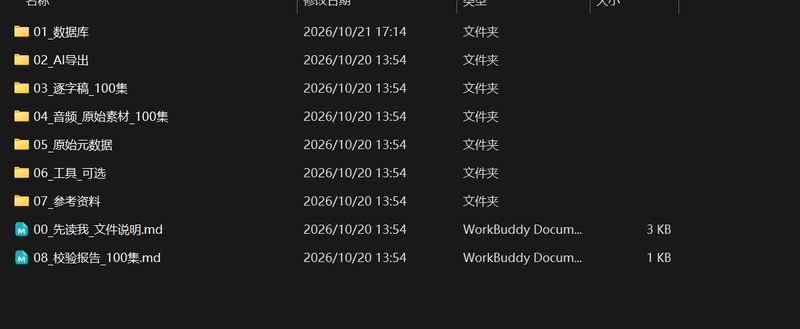
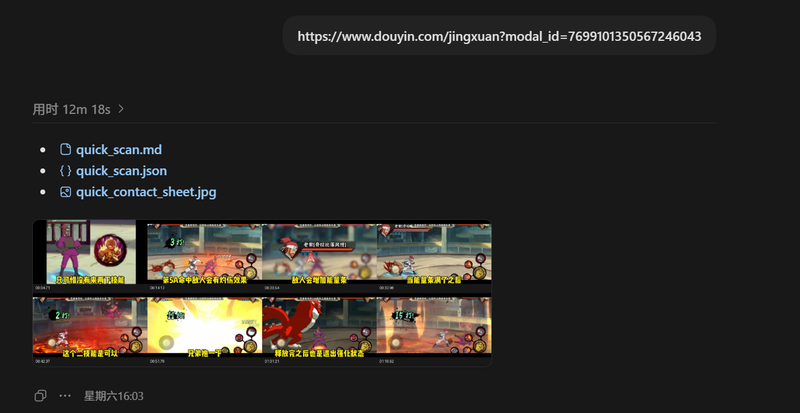
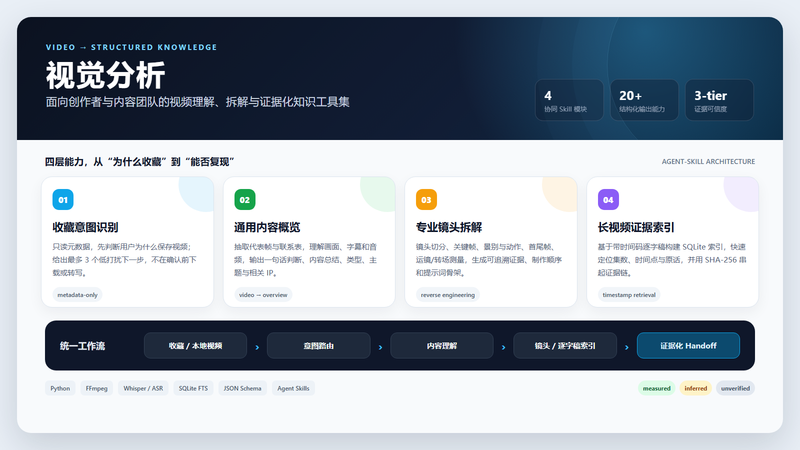
项目由四个 Skill 模块组成:① 收藏视频入口:仅读取元数据,先识别保存意图并给出低打扰的下一步建议;② 通用内容分析:抽取代表帧与联系表,输出一句话判断、内容总结、类型、主题和相关 IP;③ 专业视频拆解:完成镜头切分、关键帧、景别/动作/首尾帧、运镜与转场测量,并生成证据帧、制作顺序和提示词骨架;④ 长视频索引:基于带时间码逐字稿建立 SQLite 索引,按关键词定位集数、时间点与原话,并生成可校验的 SHA-256 证据链。系统统一输出 Markdown、JSON、JSONL、SQLite 和可选 PDF,并用 measured / inferred / unverified 标记结论可信度。
我负责产品定位、Skill 契约与信息架构、Python 脚本实现、Schema 设计、测试和发布打包。整体采用“宿主提供媒体访问 + Skill 负责确定性处理与结构化输出”的分层架构:以 Python 编排探测、抽帧、镜头切分和运镜/转场测量,FFmpeg 完成视频/音频处理,SQLite FTS 构建逐字稿与多集语料检索,JSON Schema 约束跨模型 handoff。亮点包括证据分级、时间码与哈希回溯、metadata-only 隐私边界、渐进式镜头拆解以及跨 Skill 路由;难点是把模型语义观察与确定性测量严格分离,并让长任务可分段确认、可复现、可审计。


评论