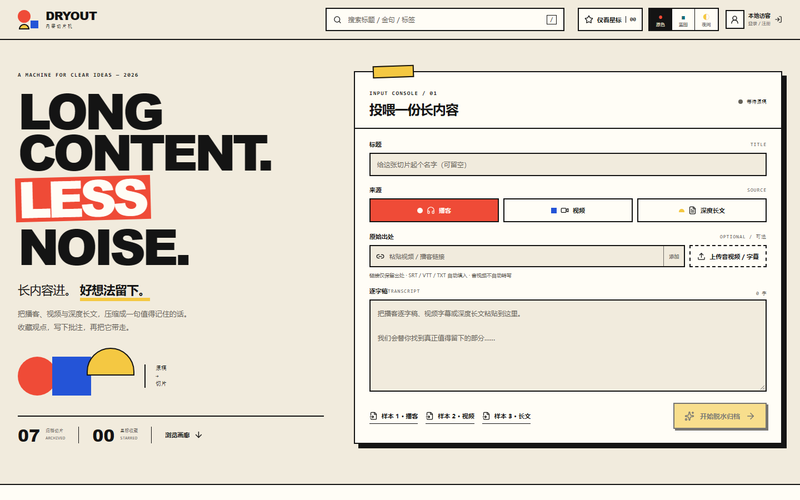
1、立项原因:播客、长视频与深度长文的信息密度低,用户习惯"先收藏再看",实际收藏夹只存不看,内容资产无法沉淀。DryOut 把"入库"和"脱水"合并成一步:粘贴网页/视频/播客链接后自动解析元数据,调用大模型提取"高光金句(60字内)+ 一句话结论(45字内)+ 三段式论据数组 + 分类标签",直接产出可检索、可收藏的结构化卡片,解决"存了不看、看了记不住"的问题。
2、行业场景:面向内容消费与个人知识管理,典型用户是播客听众、长视频学习者、研究者与内容创作者。可复用于知识付费平台的内容二次加工、企业培训资料的自动摘要归档、媒体机构的内容资产结构化等业务背景。
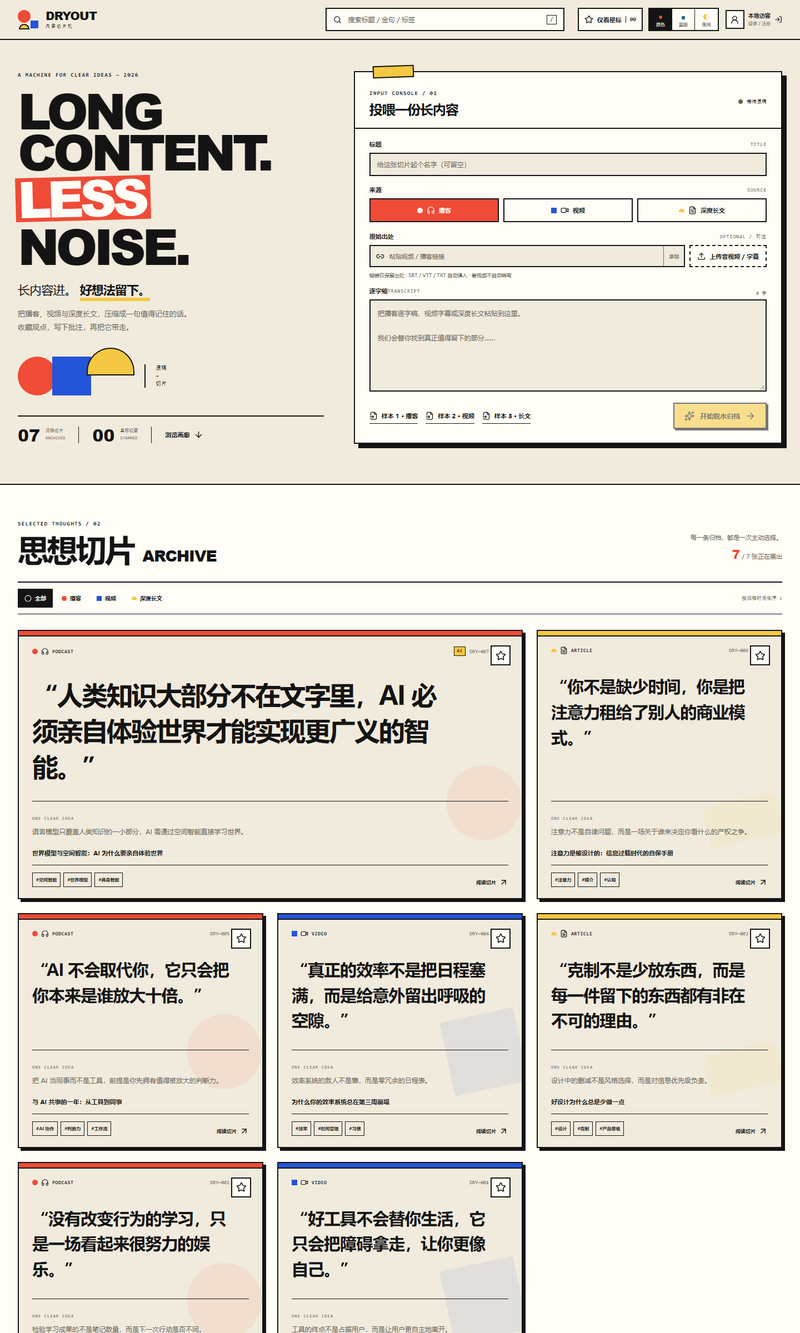
1、功能模块:① 链接投喂与元数据解析(支持网页、视频、播客 URL,自动抓取标题与正文);② LLM 结构化脱水(输出高光金句、一句话结论、三段式论据数组、分类标签四类字段);③ 馆藏画廊(卡片按入库顺序编号 DRY-001 起,支持分类筛选与检索);④ 个人星标与私有批注(登录后独立存储,与公共卡片解耦);⑤ 三套主题实时切换(原色构成 / 蓝图纸版 / 夜间展厅);⑥ 藏书票海报导出(Canvas 多配色)。
2、主要功能描述:用户粘贴一个长内容链接,系统自动解析元数据并调用大模型完成脱水,把一小时的内容压缩成一张可扫读的结构化卡片,直接进入个人馆藏。访客无需登录即可浏览 6 张预置卡片,登录后可对任意卡片加星标、写私有批注。
1、我负责的任务:独立完成产品定义与全栈落地。包括需求与功能规格定义、数据模型设计(公共卡片主表 distill_cards 与用户私有状态表拆分解耦)、验收标准制定、AI 生成代码的审查与修正、线上部署与问题排查。
2、技术栈与架构:React 19 + Vite 前端;Supabase(PostgreSQL / Auth / RLS 行级安全策略 / Edge Functions / Storage);大模型经 Edge Function 代理调用 DeepSeek;Cloudflare Pages 部署;Playwright 做端到端测试。
3、难点与亮点:① 安全——大模型 API Key 不落前端,改为 Edge Function 校验 Bearer Token 后代调,未授权请求返回 401;② 容错——未配置 Key 或调用超时时自动降级到基于 26 个中文信号词加权打分的本地启发式引擎,保证功能可用;③ 数据隔离——用 RLS 实现"访客可读预置卡片、登录用户私有状态互不可见";④ 一致性——卡片内容与个人星标/批注拆两表,用 null 与空串区分"未填写"与"主动清空",并做乐观更新 + 失败回滚。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论