

一对一物理教学中,备课时间大头花在找题上,资料又长期散落在上千份 PDF 里,主要有三类问题:
一是题目没有结构化,要找“某题型、某难度”的题只能逐份翻阅;
二是约四分之一的资料是扫描件,无法检索文字;
三是同一题型在不同讲义、月考卷里重复出现,缺少统一的题型口径,选题容易重复或遗漏。
本项目面向一对一及小班物理教学,把资料库拆成单题,按统一题型体系打标,实现按条件秒级检索。


点击空白处退出提示



一对一物理教学中,备课时间大头花在找题上,资料又长期散落在上千份 PDF 里,主要有三类问题:
一是题目没有结构化,要找“某题型、某难度”的题只能逐份翻阅;
二是约四分之一的资料是扫描件,无法检索文字;
三是同一题型在不同讲义、月考卷里重复出现,缺少统一的题型口径,选题容易重复或遗漏。
本项目面向一对一及小班物理教学,把资料库拆成单题,按统一题型体系打标,实现按条件秒级检索。
【题源处理】接入讲义、月考卷、诊断卷、近五年真题约两千份;扫描件先识别,再切成单题切片,自动剔除目录、知识讲解、答案汇总等非题内容。
【题型体系】以一轮复习 56 讲、约 270 个题型为骨架,每题标注章节、主次题型、细分模型、题目形式、难度(4 档,附判定理由)、出处,统一输出 JSONL。
【批量打标流水线】题目拆成 299 个分片,由多个大模型任务并行处理,按分片落盘,中断可续跑;汇总后分批抽查。
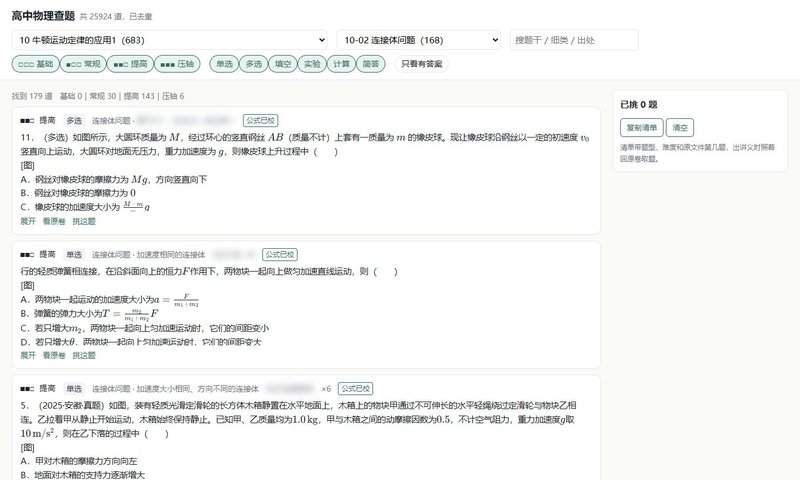
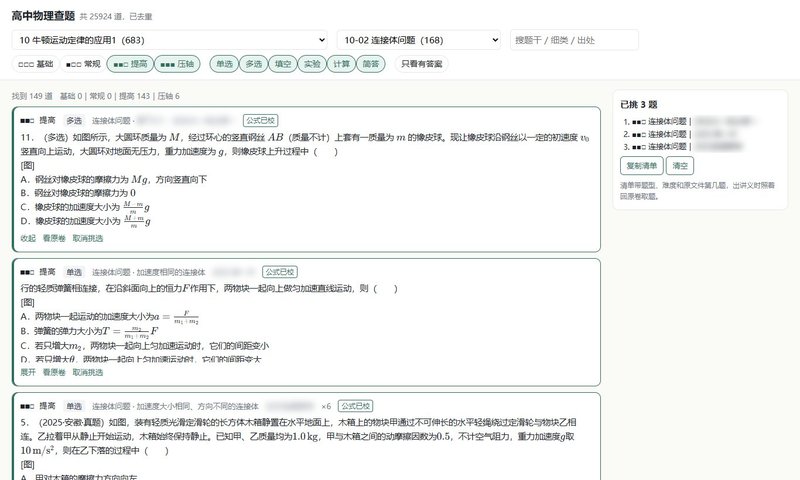
【检索页】章节、题型、难度、出处组合筛选,题目即时预览,纯本地运行,不依赖服务器。
【成果】高中部分 25924 题全部入库可查。
【规划中】按学生错题自动组卷、导出讲义 PDF、扩展到初中和其他学科。
开发过程采用 AI 辅助编码工作流,由本人负责需求拆解、架构决策、结果验收与集成调试。技术栈为 Python(题源解析、切题与批处理)+ 大模型(结构化打标)+ 原生 HTML/JS 单页检索。
三处主要难点:
其一,题源格式混杂:扫描件、跨页题、题目与答案分开存放,需要先清洗、识别再切题。
其二,并行口径一致:多个模型并行打标,标准容易漂移。先写死一份打标标准作为唯一依据,再按打标模型统计难度均值互相对照(两个模型都是 2.59,另一个 2.87),发现偏差就针对性抽查返工。
其三,长任务可靠性:近三百个分片的批量任务中途遇到额度中断,因为按分片落盘,恢复后从断点续跑,已完成部分不受影响。

评论