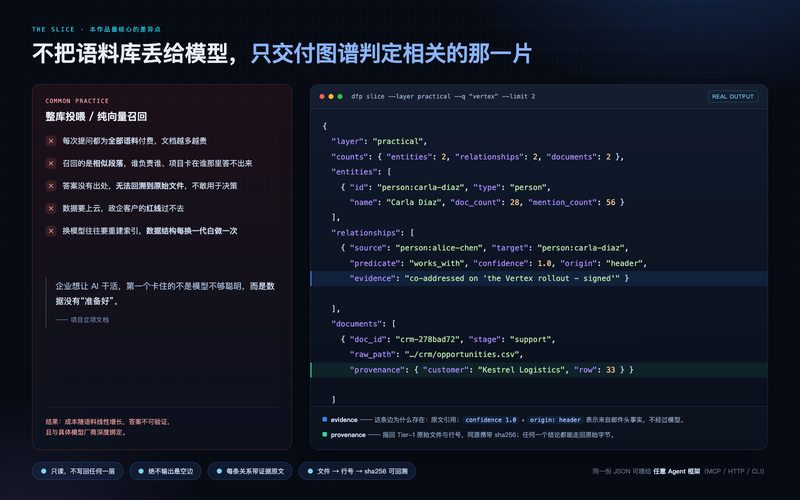
① 立项原因:企业要让 AI 真正干活,第一个卡点往往不是模型不够聪明,而是数据没有准备好——邮件、Office 文档、CRM 导出、聊天记录散落各处,格式不统一,人与项目、客户之间的关系只存在人脑里;直接把整库语料喂给大模型,每次提问都要为全部数据付费,答案还给不出出处。政企客户另有一条硬约束:数据不能出内网。
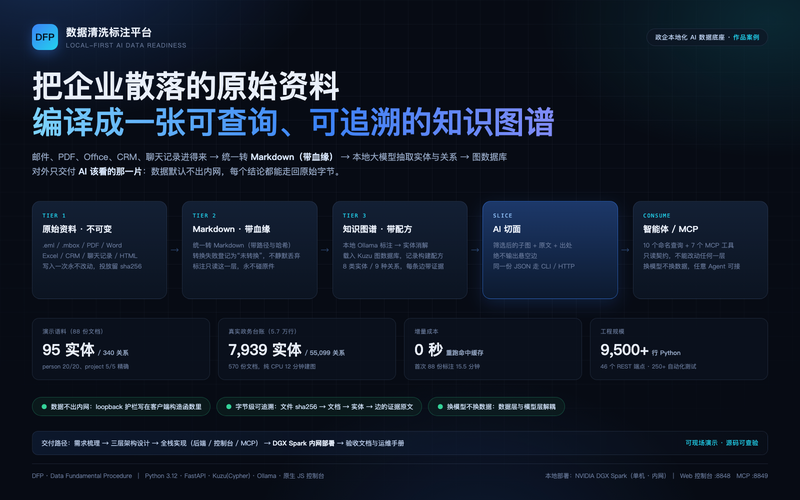
② 业务场景:销售团队要回答“谁负责这个客户”“这个项目卡在谁那里”“赢单团队和输单团队差在哪”;政务部门要把 5 万多行农村闲置资产台账变成“这块地适合包装成什么项目”;外贸企业要把询价、合同、报关、收汇串成完整链路。这些问题的答案都在“关系”里,而关系从未被结构化。DFP 做的就是把原始资料编译成一张可查询、可追溯的知识图谱,再把图谱判定相关的那一片交给智能体。
① 三层数据架构:T1 原始资料不可变(每次投放记录投放人、时间、原因与每个文件的 sha256);T2 统一转 Markdown 并携带 source_path / source_hash,转换失败显式登记为“未转换”,绝不静默丢弃;T3 本地大模型抽取实体与关系,实体消解后载入 Kuzu 图数据库。每一层都记录自己的构建配方:选了哪些文档、哪个策略、哪个模型、谁在何时构建。
② 多格式接入:.eml / .mbox、PDF、Word、Excel / CSV、JSONL 聊天记录、HTML,另有 OCR 钩子可接扫描件;按内容哈希去重,重复投放不增加数据。
③ 标注与消解:7 套抽取策略(通用 / 人物 / 项目 / 流程 / 政务 / 发票 / 外贸),固定 8 类实体、9 种关系、近 90 条同义词映射,不合契约的模型输出直接拒绝;实体消解用 union-find,宁可不合并也绝不猜。
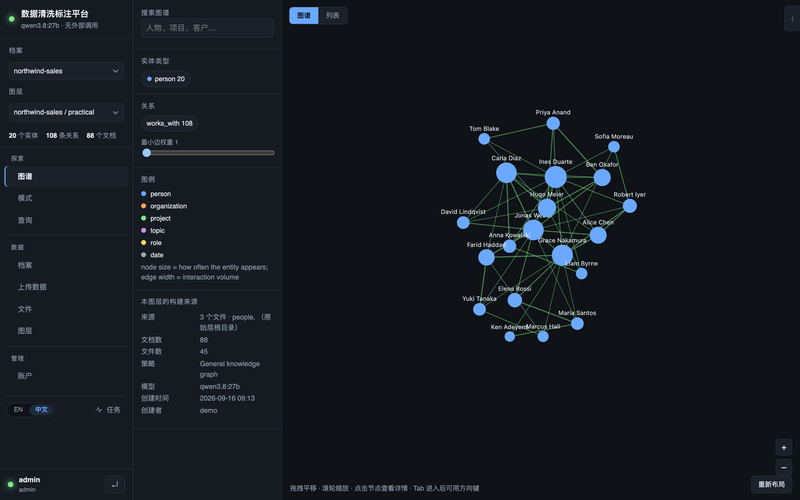
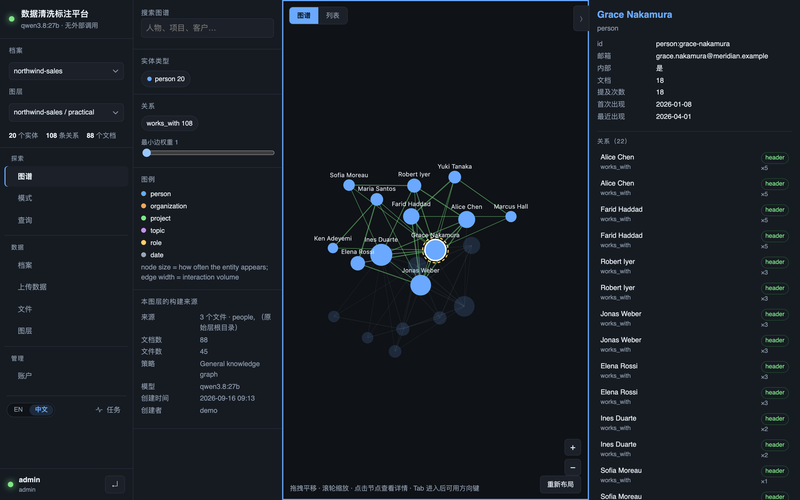
④ Web 控制台:力导向图谱(按类型着色、边宽 = 互动量,可按类型 / 关系 / 最小权重过滤)、节点详情(邮箱、职务、每条关系背后的证据原文、出现在哪些文档)、文档浏览、层管理(购物车选文档、锁定、fork、promote)、模式报告、任务中心;账号分 admin / operator / viewer,支持 API Key,中英双语。
⑤ 对外消费:10 个命名查询 + AI 切面(纯 JSON,CLI 与 HTTP 同一份实现)+ 7 个只读 MCP 工具,Claude Code、Hermes 或自研 Agent 都能直接接。
三层数据模型与 profile / layer 生命周期、FastAPI 后端(46 个 REST 端点)、零框架原生 JS 控制台、MCP 只读接口、Kuzu 图存储与查询层、标注缓存与并发调度,以及独立于仓库的中文一键部署 / 运维脚本。技术栈为 Python 3.12 + FastAPI + Kuzu(Cypher)+ 本地 Ollama + markitdown。
三个关键设计:
① 隐私是“代码构造”而不是配置默认值——标注客户端在构造函数里校验目标主机,非 loopback 直接抛异常,配置写错也发不出去;在线标注是另一条需要显式开启、且会被写进层配方的独立路径。
② 确定性主干 + 大模型增强——邮件头这类事实不经过模型,直接生成双向关系、置信度 1.0;即使模型对某份文档完全失败,这份文档也不会从图谱里消失。
③ 缓存键 =(模型, 提示词版本, 策略名:版本, 文档哈希)——88 份文档首次标注 15.5 分钟,重跑 0 秒,克隆层 0.2 秒;每周增量投放只为新文档付算力。
真实数据踩过的坑(均已修复并补了回归测试):Excel 纯数字单号被 pandas 推断成 float,3.707242e+17 让所有单据塌成一个实体;短单号 S00401 / S00402 被模糊消解误合并,扩宽保护正则后实体 220→253、关系 651→896;同一秒入库的文档让切片顺序在多次调用中给出不同结果,排序补 doc_id 才成为全序。
工程规模:约 9,500 行 Python / 37 个文件,250+ 自动化测试(无需 Ollama、无需联网即可跑),已在 NVIDIA DGX Spark 单机内网交付。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论