

公开数据个人演示,面向小样本机器学习项目的实验方案审查与模型选择。针对同源样本混入训练和验证集、反复选模型导致结论偏乐观、仅比较单次准确率等问题,构建可复现的审计流程,帮助判断模型改动是否有可靠收益。本作品非客户交付,未涉及LLM或LoRA。


点击空白处退出提示



公开数据个人演示,面向小样本机器学习项目的实验方案审查与模型选择。针对同源样本混入训练和验证集、反复选模型导致结论偏乐观、仅比较单次准确率等问题,构建可复现的审计流程,帮助判断模型改动是否有可靠收益。本作品非客户交付,未涉及LLM或LoRA。
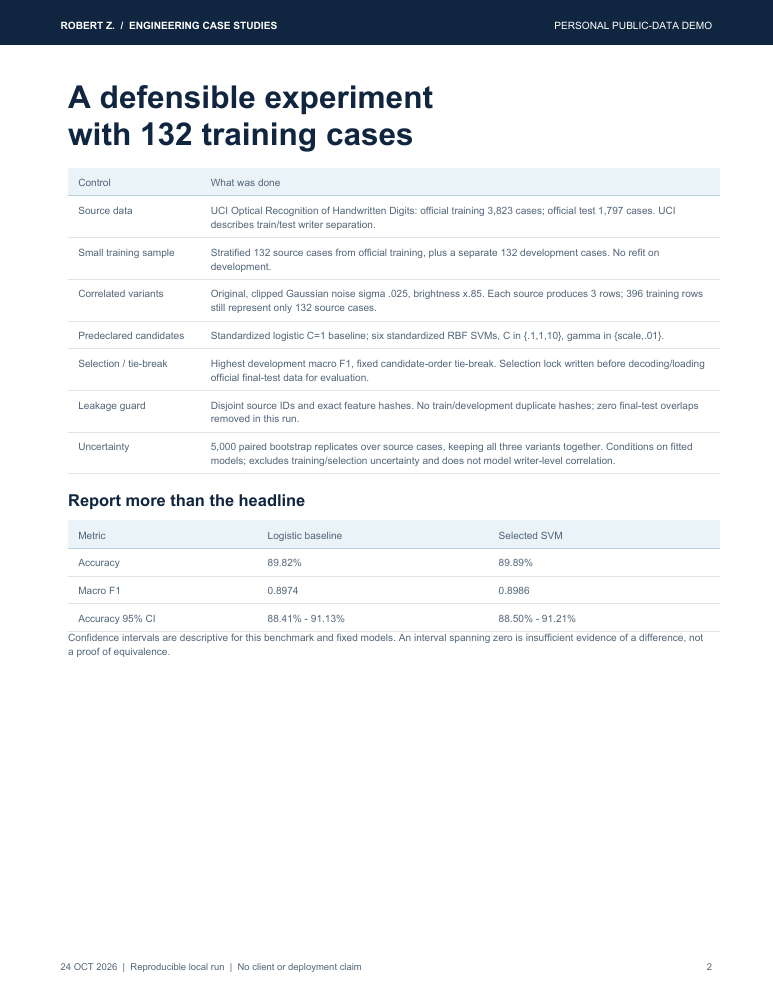
提供按源样本分组的数据划分、数据泄漏检查、开发集模型选择、独立测试集评估、配对分组Bootstrap置信区间、混淆矩阵及错误样本分析。输出审计报告、实验协议、样本清单和预测结果。明确区分选择阶段指标与最终测试结果,并报告样本规模与统计不确定性。
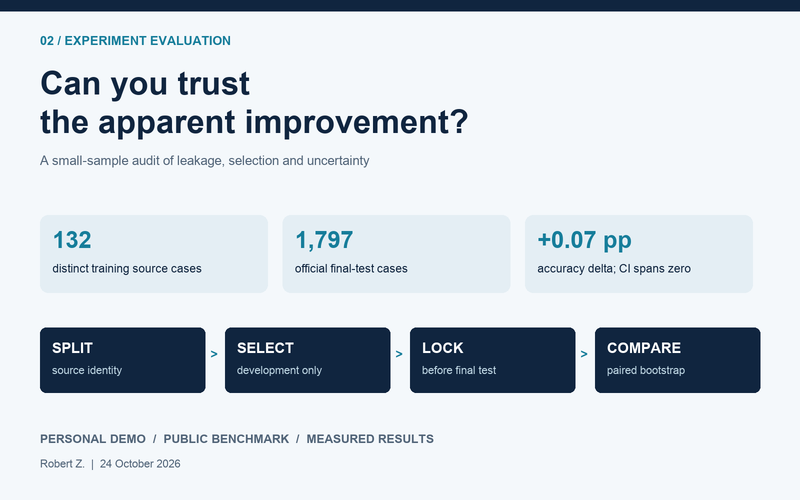
本人使用Python及scikit-learn构建完整评估流程,基于UCI optdigits公开数据,使用132个训练源样本及独立开发数据,在1797个官方测试样本上最终评估。对比逻辑回归与开发集选择的SVM,并按源样本计算置信区间。刻意构造的逐行划分诊断得分96.88%,按源分组后为91.67%,仅作为泄漏风险示例。最终所选模型准确率增益+0.07个百分点,95%区间为[-0.82,+0.93]个百分点,因此结论为没有明确收益。合成变体不作为独立样本计数。

评论