

信贷风控的模型、评分卡和拒绝规则都依赖大量用户特征。原来特征散落在各个服务里,定义、取值分布和血缘都要找开发查,特征上线没有审批和审计,实时计算慢、上游字段为空时还会让计算器崩溃。项目目标是建设统一的特征计算引擎和特征管理平台,为决策引擎提供稳定、高性能、可追溯的特征。(在职期间负责的公司内部系统)


点击空白处退出提示



信贷风控的模型、评分卡和拒绝规则都依赖大量用户特征。原来特征散落在各个服务里,定义、取值分布和血缘都要找开发查,特征上线没有审批和审计,实时计算慢、上游字段为空时还会让计算器崩溃。项目目标是建设统一的特征计算引擎和特征管理平台,为决策引擎提供稳定、高性能、可追溯的特征。(在职期间负责的公司内部系统)
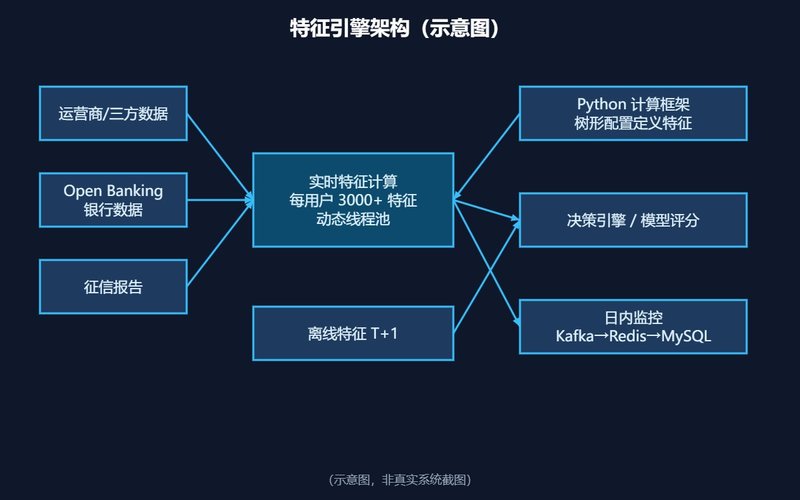
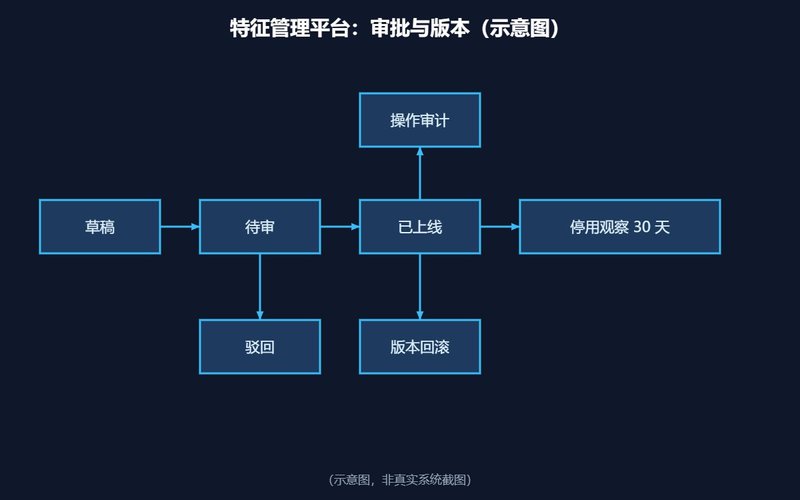
1、实时特征计算:每个用户 3000+ 特征实时计算,接入多数据源与动态线程池,支持实时、离线(T+1)和离线+实时组合三种模式。2、Python 计算框架:用树形配置文件定义数据接口和调度关系,方便机器学习同学自助开发和自测特征。3、特征管理平台:特征目录(37 个字段的契约 API)、草稿/待审/驳回/停用观察状态机、版本回滚、操作审计、特征血缘接口。4、日内监控:Kafka→Redis→MySQL,耗时分桶统计和 HyperLogLog 去重率。5、数据引擎:运营商、三方交易、Open Banking 银行数据授权与征信报告解析,为模型提供数据。
我负责服务搭建、核心模块开发和持续迭代,也是风控管理平台后端的主要作者。技术栈 Java 17、Spring Boot、Kafka、Redis、MySQL、MongoDB,以及 Python 自研计算框架。难点与解法:上游字段为空导致 5 个特征计算器崩溃、决策超时每天上百条——在取数服务层回查补齐空字段(不动特征库、不额外发版),按手机号并发取数,超时从 120s/300s 压到 10s,加 15 分钟错误阈值告警,相关异常日志从峰值每天 6800+ 降到约 300。平台上线后对齐了 2660 条特征元数据。

评论