

立项原因:解决传统移动端自动化脚本依赖固定坐标,App 一旦改版、弹窗或更换设备分辨率就失效的痛点。在 RPA(机器人流程自动化)、移动端自动化测试、以及跨应用数据采集中,传统脚本无法识别纯图片按钮和复杂 UI。本项目通过接入多模态视觉大模型,让程序像人眼一样“看懂”屏幕上的文字和图标,极大提升了自动化的稳定性,可广泛应用于自动化测试、竞品数据监控、日常考勤提效等 To B/To C 场景


点击空白处退出提示



立项原因:解决传统移动端自动化脚本依赖固定坐标,App 一旦改版、弹窗或更换设备分辨率就失效的痛点。在 RPA(机器人流程自动化)、移动端自动化测试、以及跨应用数据采集中,传统脚本无法识别纯图片按钮和复杂 UI。本项目通过接入多模态视觉大模型,让程序像人眼一样“看懂”屏幕上的文字和图标,极大提升了自动化的稳定性,可广泛应用于自动化测试、竞品数据监控、日常考勤提效等 To B/To C 场景
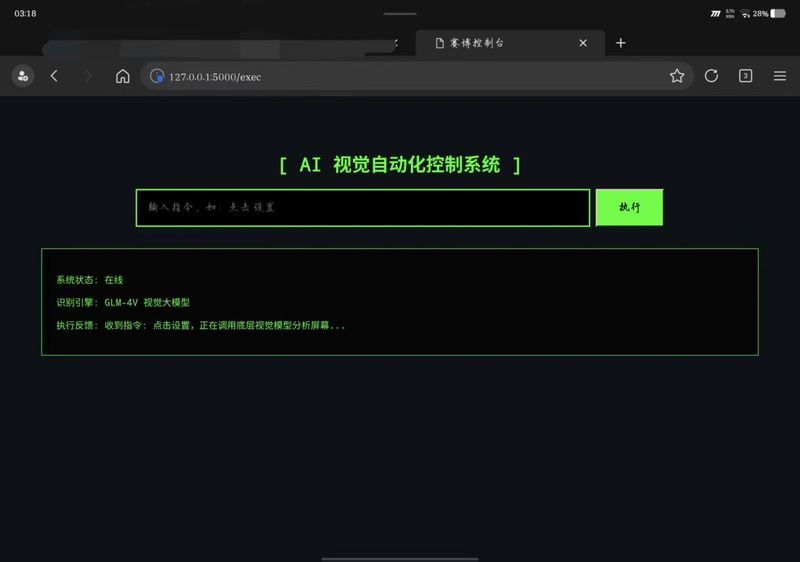
1. Web 远程中控:提供基于浏览器的控制面板,可远程输入指令,无需在设备上复杂部署
2. 多模态视觉识别:底层接入 GLM-4V 大模型,实时截图分析并返回目标元素的中心坐标
3. 底层物理注入:通过 Shizuku 获取 Android ADB 权限,实现纯物理级的模拟点击与滑动,免 Root,防平台风控
4. UI 节点解析:结合 uiautomator 进行毫秒级的本地文本正则匹配,优先极速响应,视觉模型作为兜底
本人独立完成从底层环境部署、后端接口编写到前端面板开发的全栈工作
技术栈:Python、Flask(Web 框架)、Requests、OpenCV/Pillow 图像处理、GLM-4V 大模型 API、Android ADB 协议、Termux
实现亮点:采用“本地正则极速匹配 + 云端视觉兜底”的双引擎架构;解决了多端设备连接与截图 Base64 编码传输的延迟问题;设计了完善的异常重试机制,防止屏幕动画卡死导致进程崩溃

评论