

面向视频创作者、内容团队及有跨语言传播需求的企业,针对视频翻译、配音和音视频合成需要反复切换工具的问题,将多个处理环节整合为自动化工作流。项目聚焦中文视频的英文译制,探索降低内容本地化的重复操作成本。目前处于工程原型与样片验证阶段。


点击空白处退出提示



面向视频创作者、内容团队及有跨语言传播需求的企业,针对视频翻译、配音和音视频合成需要反复切换工具的问题,将多个处理环节整合为自动化工作流。项目聚焦中文视频的英文译制,探索降低内容本地化的重复操作成本。目前处于工程原型与样片验证阶段。
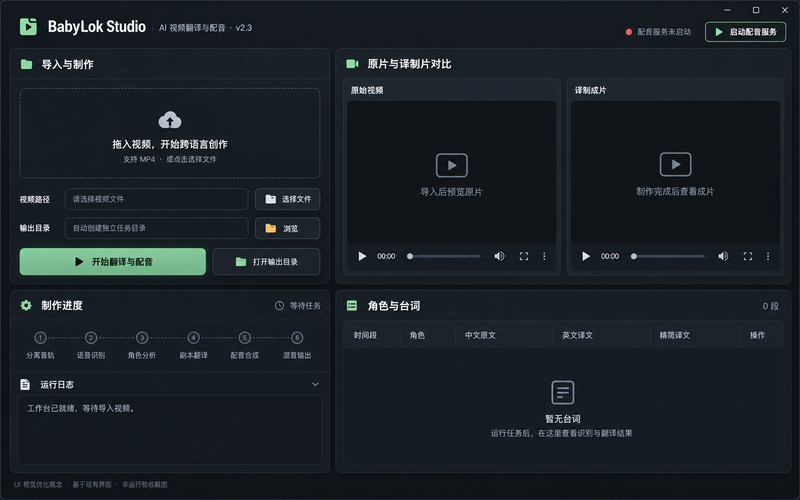
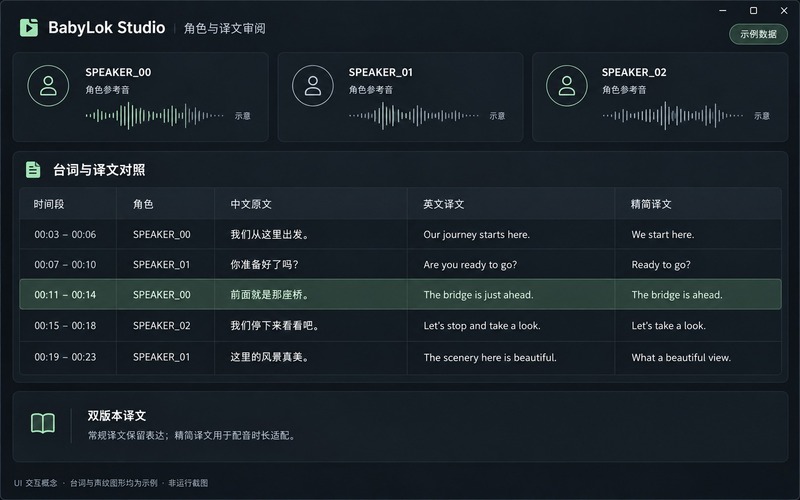
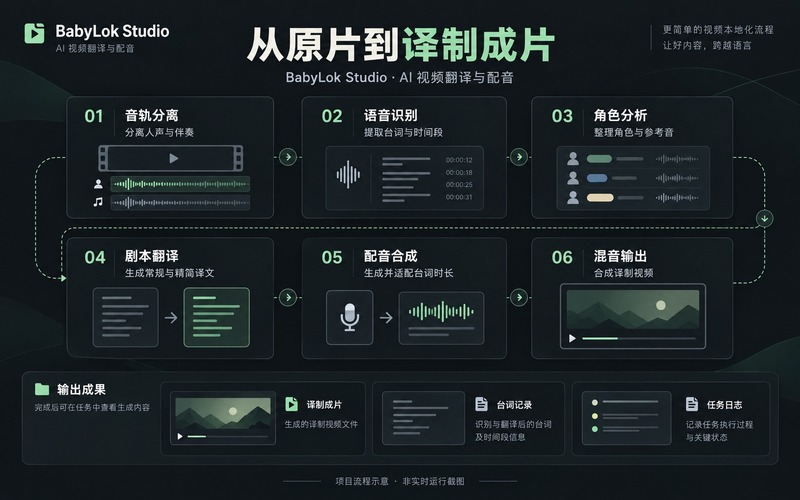
支持视频输入、原声与伴奏分离、语音识别、角色及台词时间段分析、上下文翻译、AI 配音和最终音视频合成。针对译文配音与原视频时长不一致的问题,结合长短版本译文、空隙借用和语速调整完成时间对齐;支持保留伴奏并混合生成配音。已完成样片流程验证,复杂素材的角色一致性、翻译准确性及配音自然度仍需持续测试。
以 Python 编排处理流程,结合 Demucs 进行音轨分离、Faster-Whisper 进行语音识别,通过 Qwen 系列大模型生成上下文译文,使用 Qwen3-TTS 合成配音,并通过 FFmpeg 与 Rubber Band 完成音视频处理和时长适配。工程重点包括多模型流程整合、角色参考音管理、配音时长检测、异常重试和输出版本管理。项目基于现有模型与工具开发,核心工作为应用层集成及流程优化。

评论