

随着电子商务的蓬勃发展,电商平台(如淘宝)的数据蕴含着巨大的商业价值。商家和数据分析师需要了解市场竞品价格、销量及分布情况。然而,手动收集这些数据费时费力且容易出错。本项目立项旨在解决电商数据采集门槛高、非技术人员难以操作的问题。通过提供友好的图形化界面,用户只需输入关键词和Cookie,即可快速实现淘宝商品数据的自动化采集,并一键导出为CSV文件或存入MongoDB数据库。该工具极大降低了数据获取的门槛,可广泛应用于竞品分析、市场调研、选品定价等电商业务场景。


点击空白处退出提示



随着电子商务的蓬勃发展,电商平台(如淘宝)的数据蕴含着巨大的商业价值。商家和数据分析师需要了解市场竞品价格、销量及分布情况。然而,手动收集这些数据费时费力且容易出错。本项目立项旨在解决电商数据采集门槛高、非技术人员难以操作的问题。通过提供友好的图形化界面,用户只需输入关键词和Cookie,即可快速实现淘宝商品数据的自动化采集,并一键导出为CSV文件或存入MongoDB数据库。该工具极大降低了数据获取的门槛,可广泛应用于竞品分析、市场调研、选品定价等电商业务场景。
本项目是一个基于 Python 开发的桌面端淘宝商品爬虫系统,主要包含以下核心功能模块:
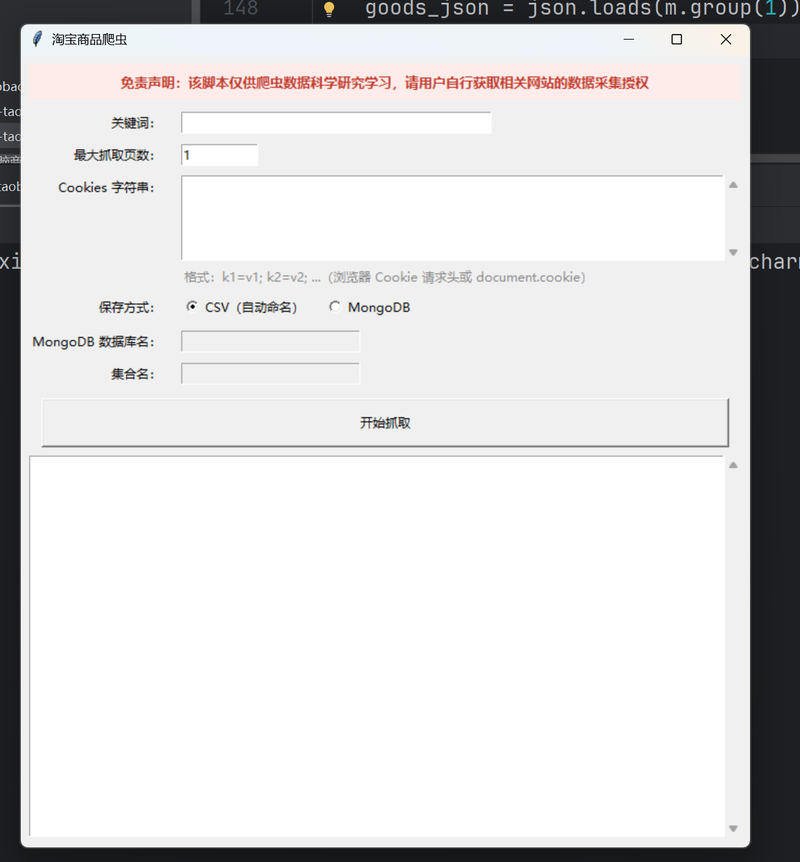
1.可视化交互界面:基于 Tkinter 构建,提供输入框供用户输入搜索关键词、最大抓取页数以及最新的 Cookies 字符串,并在窗口内实时输出带有颜色标识的抓取日志。
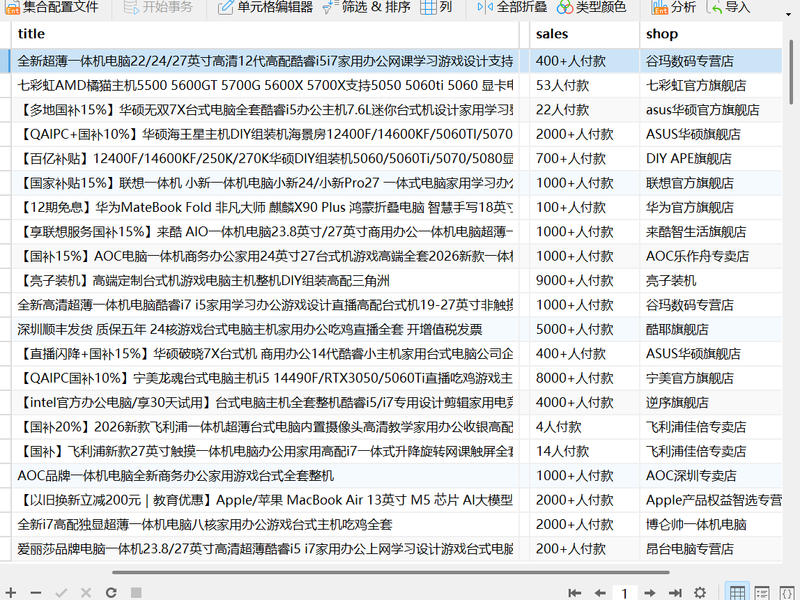
2.多页数据自动抓取:内置签名算法(md5拼接),能根据用户设定的页数自动翻页,精准解析响应报文,提取商品标题、价格、真实销量、店铺名称及发货地址等核心字段。
3.双通道数据存储:
CSV导出:采用 utf-8-sig 编码,防止Excel打开乱码。
MongoDB入库:支持用户自定义数据库名和集合名,直接持久化存储至本地数据库,方便后续分析。
4.异常安全防护:对 Cookie 失效(如缺少 _m_h5_tk 或 Token 过期)进行精准捕获,并以红色文字在UI界面提示用户重新获取,同时提供安全的线程防卡死机制。
项目采用前后端分离的思想(但打包在单文件内)。前端使用 Python 标准库 Tkinter 构建 GUI 界面,使用 queue.Queue 实现多线程间的安全通信,确保爬取时不阻塞主界面。后端核心爬虫逻辑使用 requests.Session 维持会话,通过解析用户提供的 Cookie 获取身份凭证,并利用 hashlib 生成 mtop 接口所需的 sign 签名。数据解析采用 jsonpath 精准提取嵌套 JSON 中的商品数据。数据存储层通过 pymongo 连接本地 MongoDB,或使用标准库 csv 写入文件。整体代码结构清晰,包含严格的输入校验和异常捕获机制。

评论