我长期积累的读书笔记、收藏、聊天记录散落在十几个工具里:能搜到关键词,但拼不出结构。立项目标不是做一个更漂亮的个人主页,而是搭一套能长期生长、可横向对照、且每条结论都能追溯到来源的结构化知识底座——首页只是入口,真正的产品是下面五个子站和它们共用的统计、素材与部署体系。
知识管理是个成熟赛道,但主流产品集中在"个人写作与协作"方向,面向“高密度、可验证、可视化”的知识产品是空档。具体到中文语境:
1. 历史与通识类的可视化内容,多停留在单张长图或短视频,无法交互、无法检索、无法更新;
2. 学术级的严谨度(标注争议、给出来源)与产品级的易用性(点开即读、手机可看)很少有交集;
3. 家长想给孩子讲"世界是怎么回事",缺少一套既能看全局又能钻细节的现成材料。
1. 首页
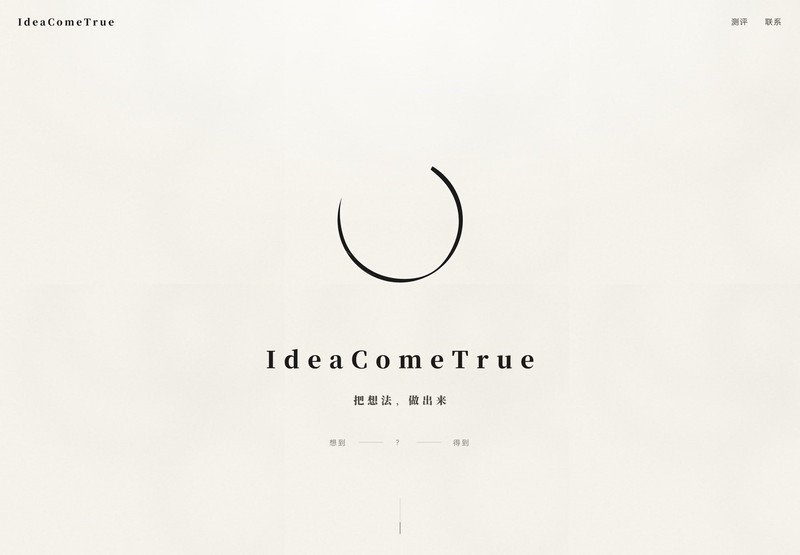
不做信息堆叠,只给入口,分别对应"做事、读史、看结构"三种动机。视觉上确立全站的禅意基调:纸白底、墨黑字、朱砂点缀,宋体为主,大量留白。
2. 职场性格测评
分层递进的问卷结构:第一层定位大类,第二层在类内细分,第三层给出行为倾向。结果页给的是带解释的描述而非单一标签,并说明这一维度在什么情境下会反转。每份结果还对应一位历史人物原型,附一段原文出处,让测评结论有可追溯的依据。
3. 毛选时空图
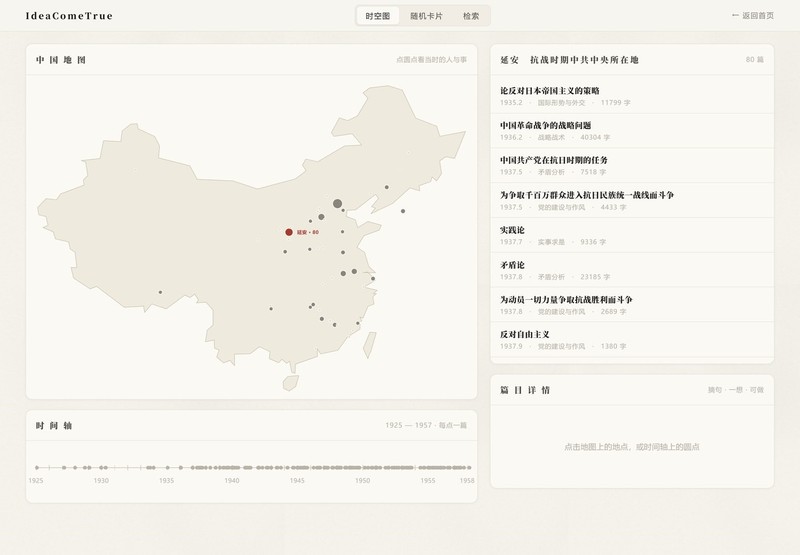
把229篇文章同时投射到两个维度上:地理与时间(1925–1976)。用户可以在图上点开某个地点看当地写成的篇目,也可以沿时间轴顺序通读;另有随机卡片与全文检索,检索支持中文模糊匹配。每篇配一张程序生成的墨色卡片图。
4. 认知图
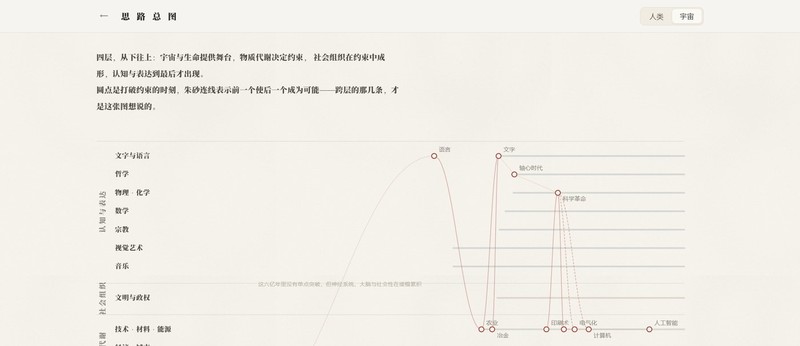
13个学科模块分布在四个层次上(认知 / 社会 / 物质 / 基底),模块之间用有向边连接,表示"A 的突破使 B 成为可能"。边的类型分三种:跨层因果(强调)、同层关联、反馈回路(虚线)。横轴是对数时间轴,覆盖 138 亿年。这里做过一次重要的自我修正:最初设想的"一条从左下爬到右上的脊椎"在数据上并不成立——重大突破在物质层与认知层之间交替出现,而非单向攀升。最终改为因果网络,并在移动端换成线性叙事列表,避免把不成立的结论画图。
本项目为个人独立完成,从产品定义到线上运维全流程一人承担。
1. 产品定义:确定"静态优先 / 零依赖 / 可离线重建"的技术边界;设计三层测评的递进结构;放弃不成立的"线性脊椎"结论,改为因果网络
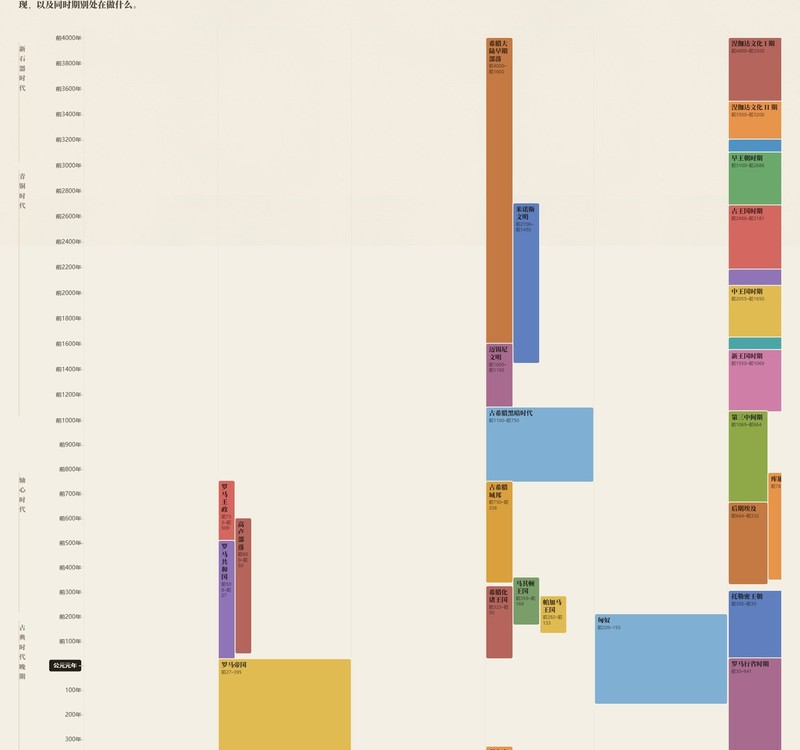
2. 信息架构:拆出 4 层 × 13 个学科模块;为世界文明史确定13个文明圈的分栏口径与时代分段
3. 视觉体系:确立纸白 / 墨黑 / 朱砂的配色与宋体排印规范;定义统一的过渡曲线、留白节奏与深色模式的强制退出策略
4. 数据整理与核验:整理 242 个政权的名称、起止年代与所属文明圈;逐条标注证据等级;为有争议条目撰写分歧说明;整理229 篇文献的写作时间与地点
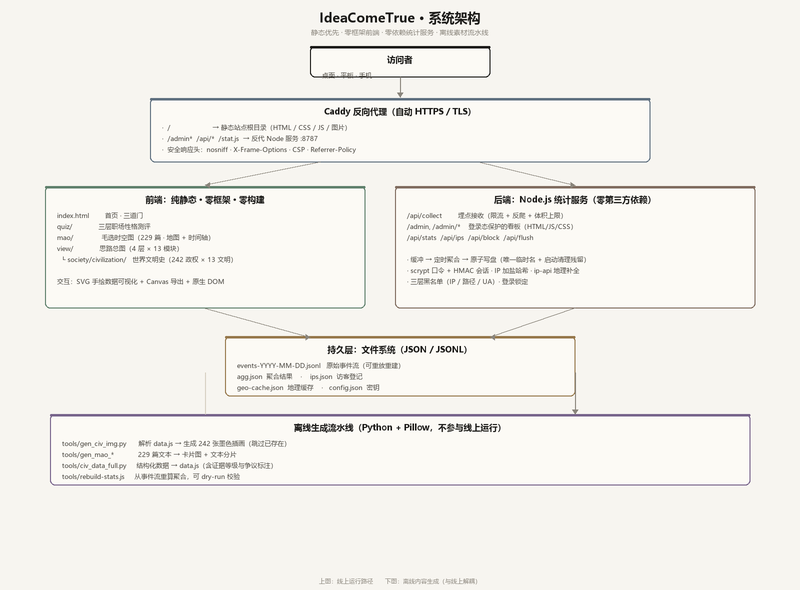
5. 前端实现:全部页面手写 HTML/CSS/JS,无框架无构建;用SVG 手绘时间轴、因果网络与地图;实现泳道装箱、自适应列宽、拖动平移、Canvas 导出与中文模糊检索
6. 素材生成:编写 Python + Pillow 流水线,程序化生成 471 张墨色插画(229 + 242);实现幂等生成(已存在则跳过),支持后续替换为真实图片
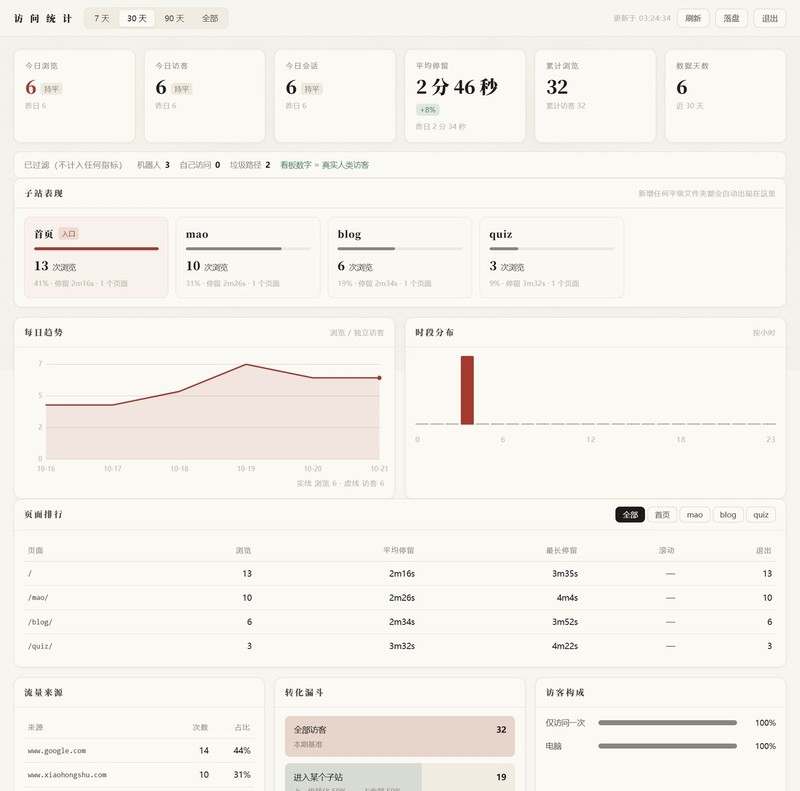
7. 后端服务:Node.js 零依赖实现埋点接收、聚合落盘、鉴权会话、IP 地理补全、三层黑名单与限流;实现可从原始事件重放的重算脚本
8. 部署运维:编写 systemd 单元、反向代理配置、权限修复与只读诊断脚本;处理日志轮转与磁盘配额
9. 安全自查:以攻击者视角对线上站点做渗透式自查,覆盖敏感路径、越权访问、注入、CSRF、上传、信息泄露等,逐项修复并复测
10. 质量保障:建立可复现的浏览器自动化校验脚本;对关键数值做双路核对(页面显示 vs 从原始事件重算)
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论