

不良资产处置的核心生产资料是公开的司法文书,但这类数据有三个特点:来源分散、格式不统一、领域术语密集。同一份破产裁定书在不同来源下的字段结构不一致,正文里夹杂大量程序性表述,真正有用的要素(债权金额、担保情况、关联企业、程序节点)藏在长文本里。早期用正则规则引擎做抽取,字段级准确率只有 20% 左右,大部分结果仍需人工复核,等于没有真正替代人工。而数据会持续新增、来源格式还会变,靠一次性脚本和不断堆规则无法规模化——规则越多,维护成本越高,一处格式变动就会引发大面积失效。


点击空白处退出提示



不良资产处置的核心生产资料是公开的司法文书,但这类数据有三个特点:来源分散、格式不统一、领域术语密集。同一份破产裁定书在不同来源下的字段结构不一致,正文里夹杂大量程序性表述,真正有用的要素(债权金额、担保情况、关联企业、程序节点)藏在长文本里。早期用正则规则引擎做抽取,字段级准确率只有 20% 左右,大部分结果仍需人工复核,等于没有真正替代人工。而数据会持续新增、来源格式还会变,靠一次性脚本和不断堆规则无法规模化——规则越多,维护成本越高,一处格式变动就会引发大面积失效。
1. 数据采集:按来源站点分别适配抓取规则,处理分页、限流、增量更新与失败重试。
2. 数据清洗与治理:字段归一、去重、正文与附件结构化拆分,输出统一 schema,并记录数据血缘。
3. 文书智能解析:RAG 切片检索增强 + ReAct Agent 编排,按业务问题抽取要素(金额、期限、担保、关联方、程序节点等)。
4. 检索与分析:支持按案由、时间、地域、当事人等维度组合检索,并做聚合统计。
5. 链路调度与监控:采集、清洗、解析三段独立可重放,每段都有失败告警与重跑入口。
6. 结果校验:模型抽取结果与规则校验交叉验证,低置信度结果进入人工复核队列。
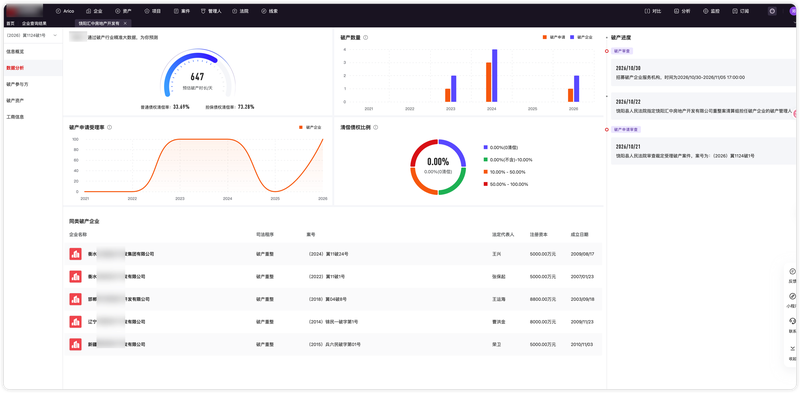
7. 业务服务:提供数据汇总服务与AI自动化数据查询服务
我负责整条链路的选型与实现:采集适配、清洗规则、语料构建、切片策略、检索与 Agent 编排。
技术栈:Java(服务与调度)、Python(数据处理与模型侧)、Milvus 向量库、对象存储、Kubernetes。
亮点——把"规则驱动"换成"检索增强 + Agent 编排":破产文书的表达变体太多,规则越堆越脆。改为先按语义边界切片、检索出相关段落,再由模型在受控上下文内抽取,规则只保留做后置校验。字段级准确率由 20% 提升至 80%,人工复核量随之下降。
难点——切片策略:按固定长度切会把条款与它的适用条件切断,模型拿到的是半句话,答案必然偏。改为按语义边界切片,并保留章节层级作为检索过滤条件。
难点——模型可替换性:上游供应商单方面下线旧模型版本,且通知到得晚,线上链路随时可能整体不可用。完成版本迁移与推理接口重构,把模型调用从业务代码中抽出成独立层,参数、重试、超时、降级在此层统一处理。切换在旧版本下线前完成,服务未中断;后续再换模型不再需要改动业务代码。
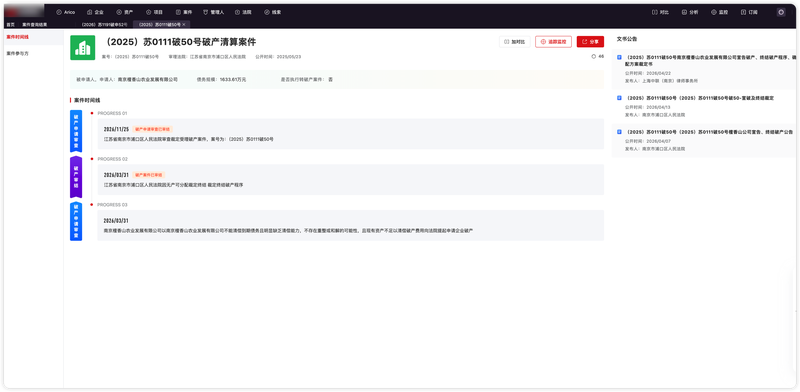
结果:累计爬取破产文书 166 万份,形成结构化可用样本库;解析方案由规则驱动升级为模型驱动。

评论