

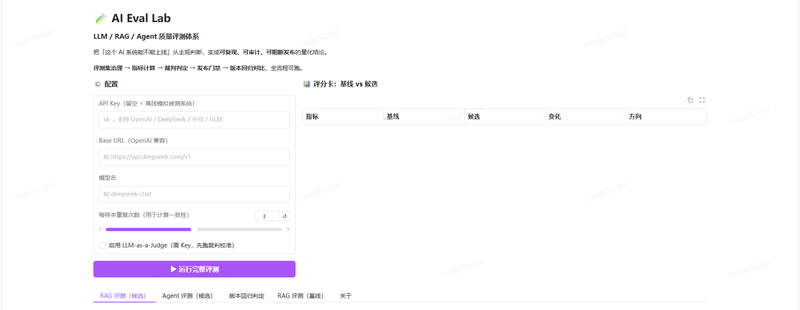
面向大模型应用(AI 助手、智能客服、生成式工具)上线前的质量评估场景。LLM 输出具有不确定性和幻觉问题,传统断言式测试无法覆盖——"同一输入多次输出不一致""不同模型孰优孰劣""评分是否可靠"是 AI 应用质量把关的核心难题。本引擎提供评测集管理、自动化评分与多模型对比能力,可作为 AI 应用发布前的质量门禁。


点击空白处退出提示



面向大模型应用(AI 助手、智能客服、生成式工具)上线前的质量评估场景。LLM 输出具有不确定性和幻觉问题,传统断言式测试无法覆盖——"同一输入多次输出不一致""不同模型孰优孰劣""评分是否可靠"是 AI 应用质量把关的核心难题。本引擎提供评测集管理、自动化评分与多模型对比能力,可作为 AI 应用发布前的质量门禁。
- 评测集管理:黄金样本(输入+期望要点)的创建、版本管理与批量执行
- LLM-as-a-Judge 自动评分:用大模型对输出质量自动打分(准确性/完整性/格式合规多维度)
- 评分偏差处理:内置位置偏好消除(AB 顺序交换)、多次采样平滑评分漂移、评分理由留痕可审计
- 多模型/多版本对比:同一评测集横向对比不同模型或不同提示词版本的得分,输出对比报告
- 质量门禁:设定通过阈值,评测不达标即拦截发布;评测报告自动输出
- 交付形态:Web 界面在线使用(ModelScope Studio),评测集与报告可导出
- 独立完成评测流程设计、评分器实现、偏差校正与报告输出
- 评分可靠性设计:针对 LLM-as-a-Judge 的已知偏差(位置偏好、评分漂移、冗长偏好),采用"交换顺序双评 + 多次采样取中位 + 评分理由强制输出留痕"的校正组合
- 评测维度设计:准确性、完整性、格式合规、拒答合理性四维评分卡,贴合生成式应用的实际质量要求
- 项目成就:已上线 ModelScope,可在线演示;为 AI 应用提供可复用的"评测集 + 自动评分 + 门禁"闭环,评测从人工抽检变为全量自动回归


评论