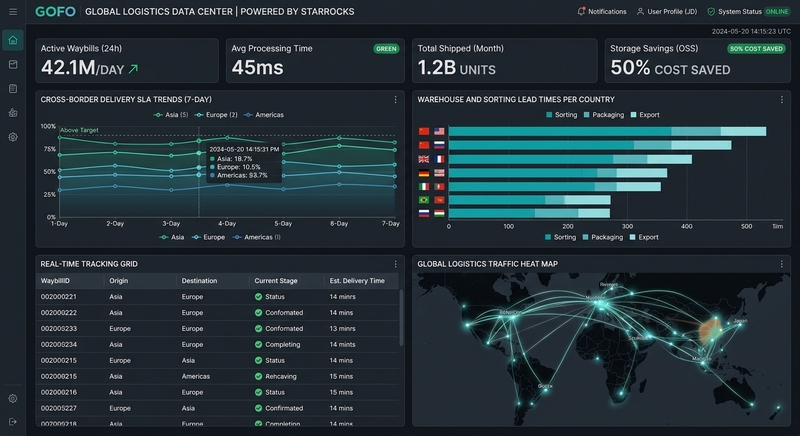
• 跨境电商物流与供应链履约分析场景:在全球跨境电商基础设施与国际物流业务中,一笔运单的生命周期极长,跨越货品海外仓储、境内外分拣、包装包材、跨国集运配送以及跨国退换货等多维长链路履约状态。系统需要支持从中心看板、站点看板等多视角进行高并发、多维下钻的数字化管理。
• 长异步链路与冷热分级存储瓶颈场景:由于每日新增运单突破 4000 万条(年均百亿级数据量),且各仓配环节的状态更新存在长达数周的“异频异步”特征。传统依赖 Canal 抽取至 MySQL 频繁执行 UPDATE 或通过 Java 消费端在内存中拼接多流的模式极易引发长达数小时的严重积压,且海量历史归档数据全量存放在物理机列存中会产生灾难性的存储成本与扩容压力。
• 全链路物流状态秒级捕获与流式加工:利用无锁 CDC 技术实时抽取跨国各业务节点源表变更,自动按运单号汇聚“仓、拣、配、退”全生命周期状态轨迹。
• 多维长异步链路状态流式增量拼宽:取代传统内存关联,在统一的湖仓存储层利用流式合并引擎对数周内陆续到达的履约片段字段进行后台异步增量缝合。
• 极致存算分离与湖仓联邦报表分析:构建面向高并发点查的热数据本地内表,与对接对象存储的冷数据湖外表。支持跨时区、跨季度、长周期物流趋势看板的多维下钻与秒级极速联邦查询。
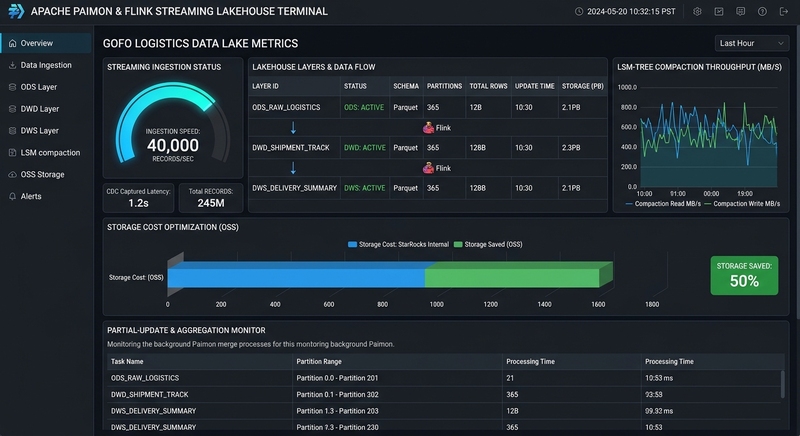
• Flink CDC 增量快照无锁捕获与秒级传输:使用 Flink CDC 增量快照读取(Incremental Snapshot Reading)技术,实现源头多台跨境业务 MySQL 实例的高效无锁并发读取。彻底简化了传统“Canal + 中间队列”的冗长管道,将数据变更捕获端到端延迟控制在秒级。
• Apache Paimon 主键模型与 LSM 异步多流拼接:选用 Apache Paimon 作为统一流式数据湖(统一存储层),规范建立 ODS/DWD/DWS 湖上数仓体系。针对多流异步长链路痛点,将 Paimon 设置为 Primary Key 模型并启用 Partial-Update / Aggregation 合并引擎,使 Flink 仅需增量写入运单最新片段,由 Paimon 底层利用 LSM-Tree 结构在后台自动、流式合并多流拼宽字段,彻底根治了消息积压,时效从积压 2+ 小时降低至 5 分钟内。
• DataWorks流批一体编排与Paimon列式压缩:依托阿里云 DataWorks 开发治理平台,ODS 层承载原始轨迹流,DWD/DWS 层通过流式 SQL 算子进行清洗和维表拓宽(Join 静态国家/站点/渠道维表)并以极高压缩比的 Orc/Parquet 落地。DataWorks 统一编排实时流任务与微批离线调度,完美实现流批一体化加工。
• StarRocks + Paimon 极致存算分离与冷热分级自治:为打破物理机扩容成本天花板,设计了“仓湖自治”的冷热解耦架构。
• 热数据(30天内活跃运单):直接导入 StarRocks 本地存储(内表),全力支撑站点看板与中心看板的瞬时高并发点查。
• 冷数据(30天至1年以上的历史归档运单):通过 Flink 定时归档到部署在低成本分布式对象存储(阿里云 OSS)上的 Paimon 湖中,实现存
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论