心理健康与压力管理这类培训,课程多半是录音:讲座、练习引导、案例讲解都在音频里,内容不假,但谁也检索不了。学员想找「讲呼吸练习的是哪一节」、咨询师想确认「某个方法在第几章」,只能整段回听,一次十几分钟。这类机构通常攒了几十到上百小时音频,越积越用不上,最后变成归档资料。
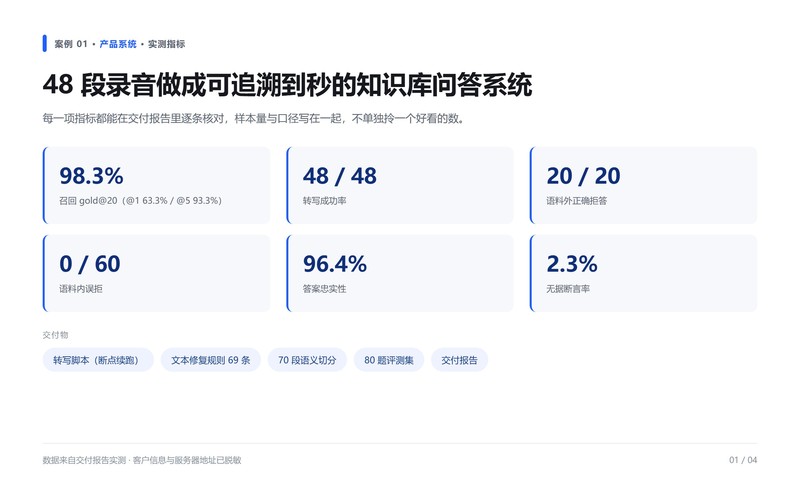
这个项目的语料是 48 个录音文件、2.22 小时、21,578 字,内容为公开出版的中文版图解指南。客户的要求不是「能聊」,而是答案必须能定位到具体章节与练习——使用者要按指引去操作,给一段没有出处的总结等于没用。音频语料比文档多两道工序:转写和断句,转写出来的错字会直接污染后面的检索。
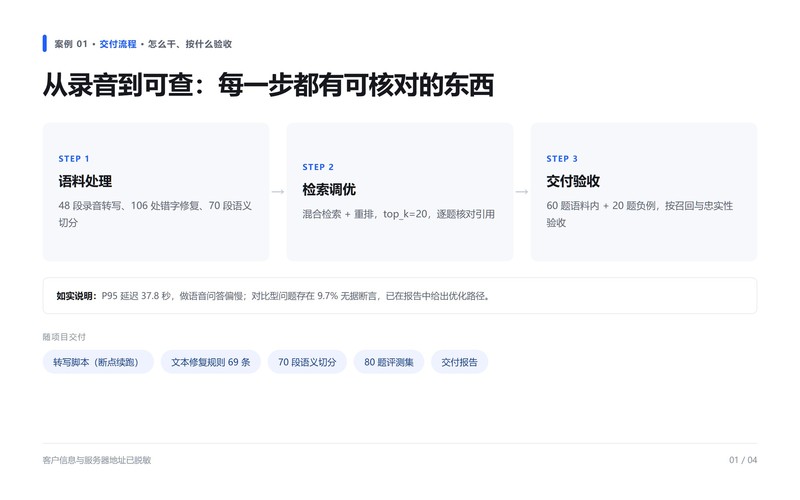
一是批量转写:本地跑语音识别,48 个文件全部转成文本,支持断点续跑,进程被杀后重跑不产生重复片段。二是文本修复:统一全角半角、修正同音错字、按时间戳重建标点,让机器转出的文本能被正常切分。三是语义分段:按语义边界切成 70 段,每段保留时间戳与来源,保证答案能回溯到秒。四是检索层:全文与向量混合检索,加重排模型取前 20 条候选,降低「答得像但引错段」的概率。五是问答流水线:问题改写、检索、生成五步串联,语料外的问题明确拒答而不是硬答。六是评测集:60 道语料内题加 20 道语料外负例,逐条核对引用与断言。
从语料处理到评测由我独立完成:转写脚本、文本修复规则、分段策略、知识库配置、问答流程搭建、评测集构造与逐条复核都是我做的;客户提供原始音频并确认行业口径。技术栈是 faster-whisper(CPU 实时率 0.052)、Dify 1.17.1、混合检索加重排模型、top_k=20。难点在转写质量:识别器把专业词写成同音字,检索时问题与文档对不上,表现是「明明有这段却搜不到」。做法是先统计错字模式,写成 69 条替换规则,修掉 106 处,逐条回归确认误伤为 0;再按时间戳重建标点,避免断句错位把一句话切两半。分段的另一个坑是跨章节:一段话横跨两个练习,命中后引用会指错,我按章节边界强制切分,最终 70 段里跨章节 0 段、碎片 0 段。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论