




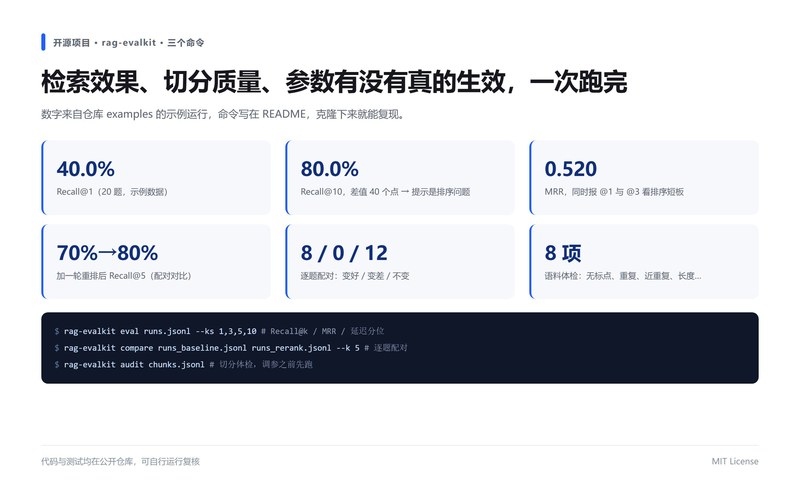
1. 功能模块。eval:算 Recall@k(支持多个 k)、MRR、延迟 P50/P95,一题多标准答案时命中任一即算召回。compare:两次运行之间做逐题配对对比,输出变好/变差/不变三类,全部一致时给出 identical 标记。audit:切分质量体检,统计无标点片段率、完全重复率、近重复对、长度分布与中文占比。
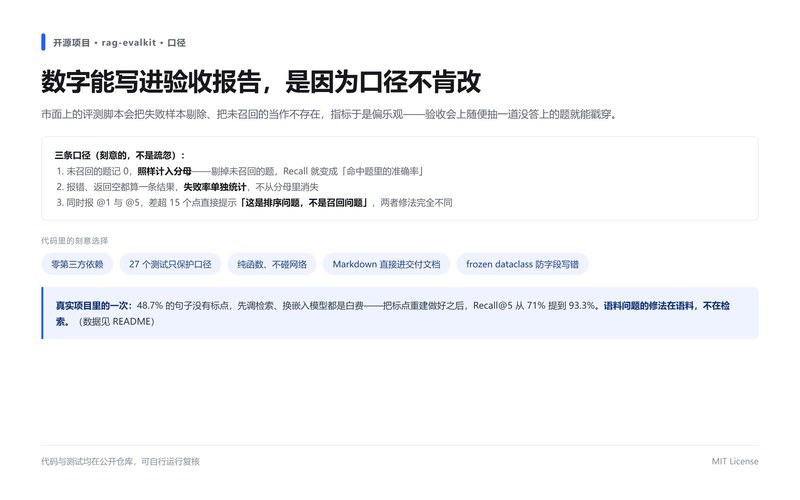
2. 业务描述。RAG 项目验收时往往缺一个站得住脚的数字。常见评测脚本会把报错和未召回的题从分母里剔掉,指标于是偏乐观——甲方随便抽一道没答上的题就能戳穿。这个工具把未召回的题记为 0 并计入分母,失败率单独统计,同时报 @1 与 @5、差值过大时直接提示「这是排序问题,不是召回问题」。三个命令都输出 Markdown,可直接贴进交付文档;零第三方依赖,Python 3.10+ 即可运行,27 个测试全部围绕指标口径的正确性。



点击空白处退出提示
评论