

高校植物分子实验室的胁迫实验会产生多批次、多字段的原始数据,常见问题是字段不统一、缺失值处理随意、图表风格不一致,导致组会汇报和论文投稿反复返工。该项目针对这一场景,建立从原始表到可发表图表的固定流程,减少重复劳动和人为错误。


点击空白处退出提示



高校植物分子实验室的胁迫实验会产生多批次、多字段的原始数据,常见问题是字段不统一、缺失值处理随意、图表风格不一致,导致组会汇报和论文投稿反复返工。该项目针对这一场景,建立从原始表到可发表图表的固定流程,减少重复劳动和人为错误。
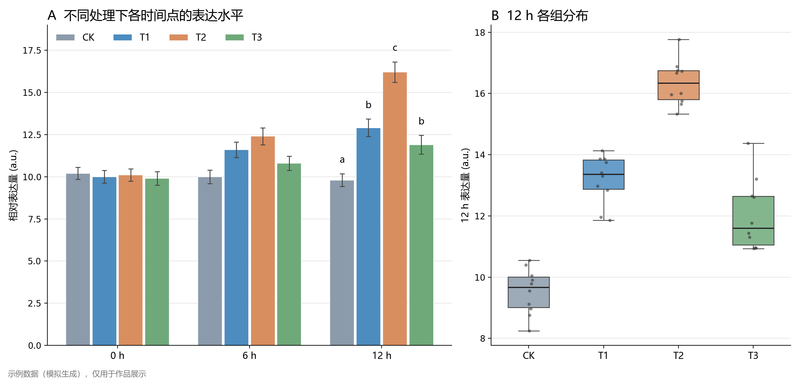
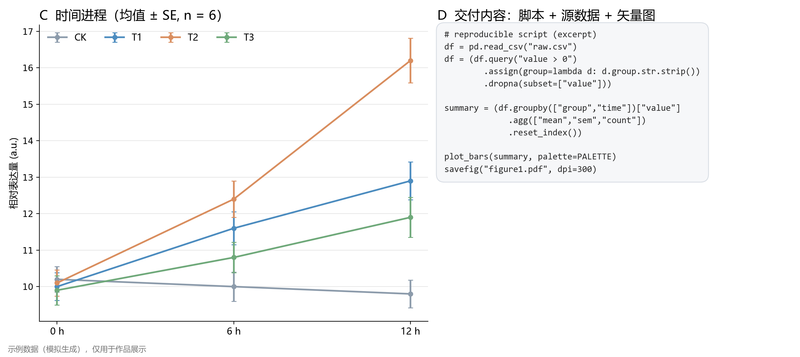
项目包含四个模块:一是数据合并,读取多个 CSV/Excel 并按处理组、时间点、重复编号对齐;二是清洗,统一字段与单位、剔除异常值、标记缺失;三是统计,计算均值、标准误并完成组间比较;四是出图,生成柱状图、箱线图和时间进程图,自动添加误差棒和显著性字母,输出 PDF/PNG 与可复现脚本。
Python 3.10 + pandas 做数据层,NumPy 做统计计算,Matplotlib 做绘图。代码按读取、清洗、统计、绘图四步拆成函数,参数集中在配置文件;输出目录按图号命名,脚本可直接重跑。交付附运行说明和数据字典。

评论