

业务、运营和财务人员日常大量使用 Excel 或 CSV 表格,但想快速了解一份数据的整体情况(字段类型、缺失、分布、趋势、相关性)时,往往要写 Python 脚本或在 Excel 里反复做透视表和图表,门槛高、耗时长;同时很多数据涉及业务隐私,不方便上传到在线 BI 平台。本项目定位为一个开箱即用的本地数据探索工具:拖入文件即可自动生成数据画像和可视化报告,数据全程只在浏览器内处理,不上传任何服务器,适用于电商销售、运营报表、财务明细、实验数据等表格类数据的快速分析场景。


点击空白处退出提示



业务、运营和财务人员日常大量使用 Excel 或 CSV 表格,但想快速了解一份数据的整体情况(字段类型、缺失、分布、趋势、相关性)时,往往要写 Python 脚本或在 Excel 里反复做透视表和图表,门槛高、耗时长;同时很多数据涉及业务隐私,不方便上传到在线 BI 平台。本项目定位为一个开箱即用的本地数据探索工具:拖入文件即可自动生成数据画像和可视化报告,数据全程只在浏览器内处理,不上传任何服务器,适用于电商销售、运营报表、财务明细、实验数据等表格类数据的快速分析场景。
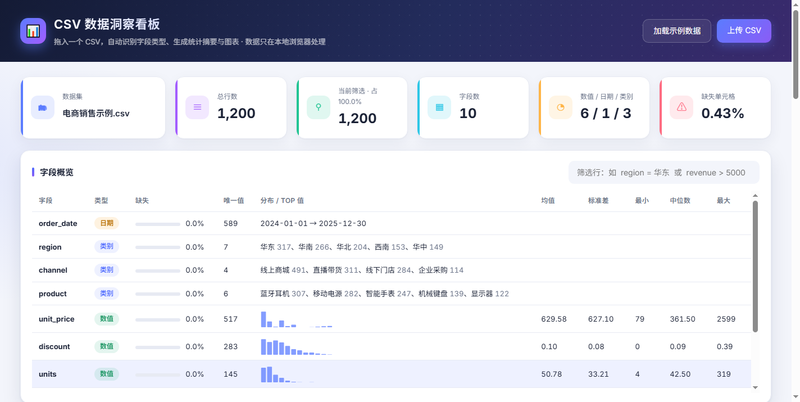
1. 数据导入:支持拖拽或选择 CSV 文件,自动解析表头,兼容千分位数字、百分比与多种日期格式;内置一份 1200 行的电商销售示例数据,一键演示。
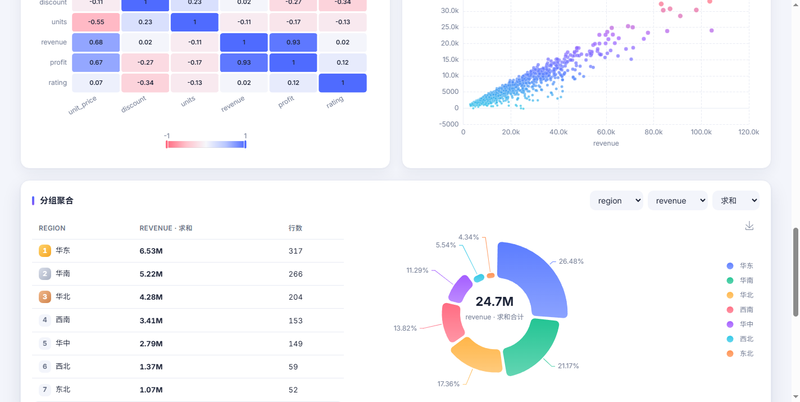
2. 自动字段画像:自动识别数值、日期、类别三种字段类型,统计每列的缺失率、唯一值、均值、标准差、最小值、中位数、最大值,数值列附迷你分布图,类别列列出 Top 值。
3. 条件筛选:支持 region = 华东 and revenue > 3000 这样的筛选表达式(= != > >= <
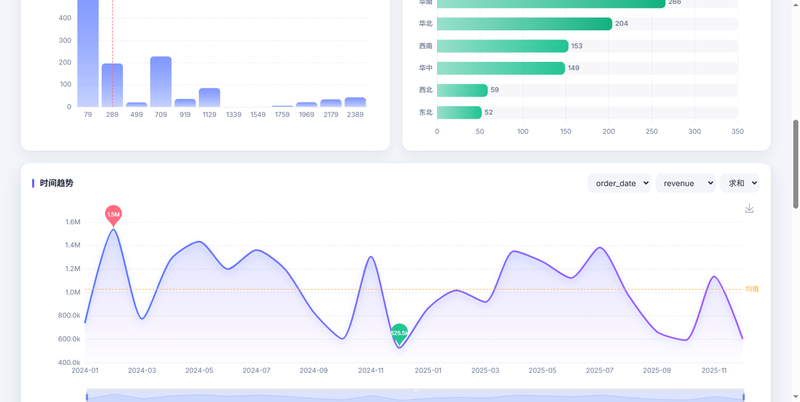
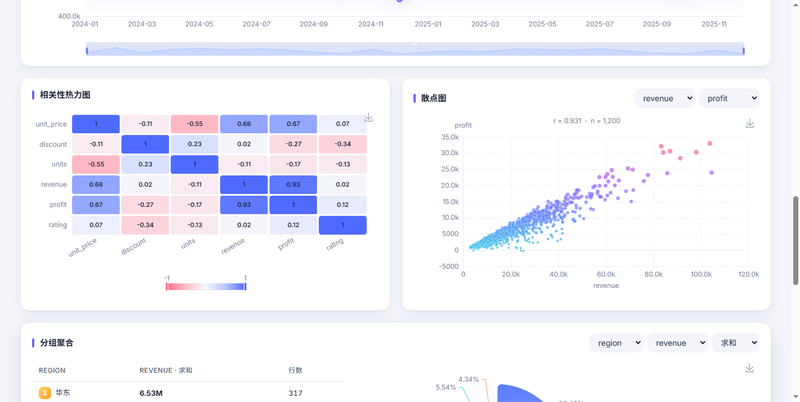
我负责项目的需求设计、交互设计和前端实现。技术上采用原生 JavaScript,不依赖框架和打包工具,部署只需任意静态服务器;使用 PapaParse 解析 CSV,Apache ECharts 绘制图表,CSS 变量实现亮色/暗色主题和移动端自适应。实现亮点:1)基于抽样和正则的字段类型推断,能处理千分位、百分比和多种日期格式;2)实现了一个轻量的筛选表达式解析器,把文本条件编译成过滤函数,支持多条件组合并按字段类型比较;3)分位数、直方图分箱、皮尔逊相关系数、分组聚合等统计计算全部在前端完成,数据不出浏览器;4)智能默认值,如趋势图自动选择总量最大的数值列、散点图自动选择相关性最强的一对字段,打开即有有意义的图。

评论