

券商研报与财报信息量大、术语密集,投资者检索产能利用率、良率、营收预测等关键数据时,常需手动翻阅多份PDF,效率低且易遗漏、转述失真。本项目面向半导体(如中芯国际等)研报与财报场景,构建可溯源问答系统,帮助投研者快速获取准确数据。


点击空白处退出提示



券商研报与财报信息量大、术语密集,投资者检索产能利用率、良率、营收预测等关键数据时,常需手动翻阅多份PDF,效率低且易遗漏、转述失真。本项目面向半导体(如中芯国际等)研报与财报场景,构建可溯源问答系统,帮助投研者快速获取准确数据。
研报解析:自动解析PDF,支持跨页表格合并与图表数据提取。
索引构建:按文档结构智能切分,建立向量索引。
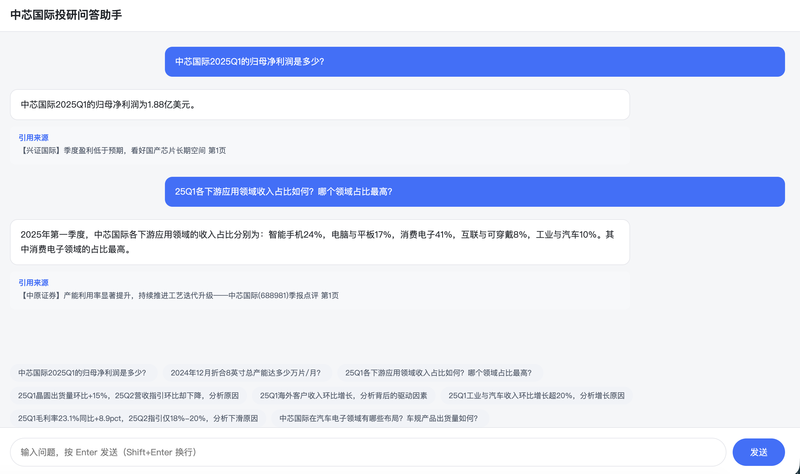
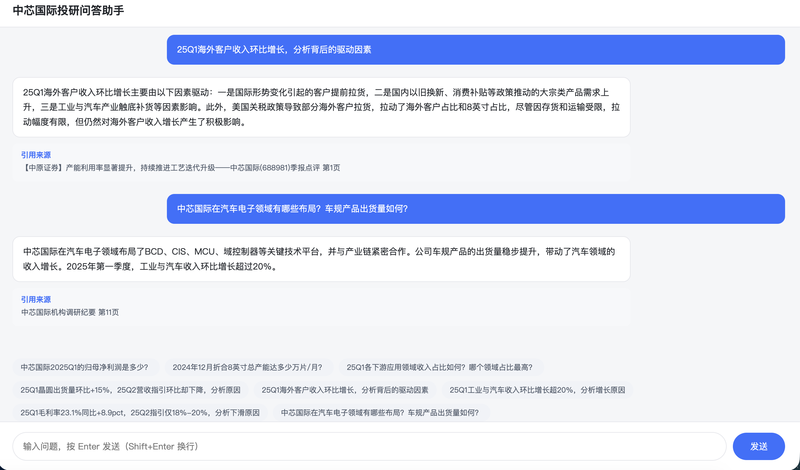
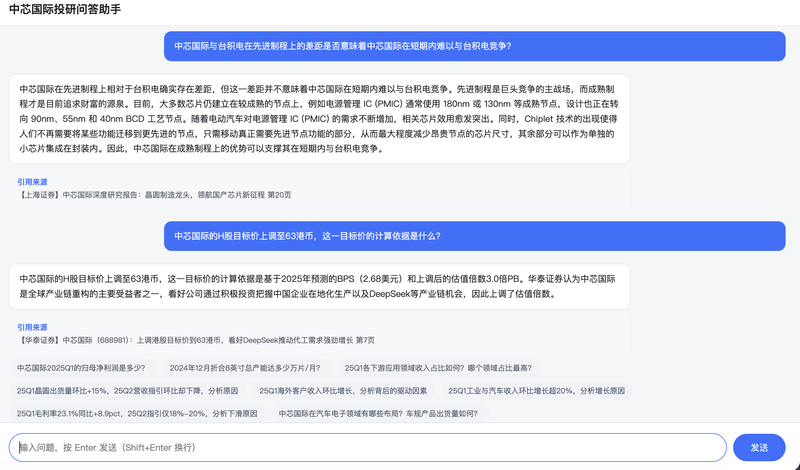
问答检索:输入问题返回答案,附带文档来源与页码。
数字保真校验:自动核对答案关键数字与原文,不一致触发修正。
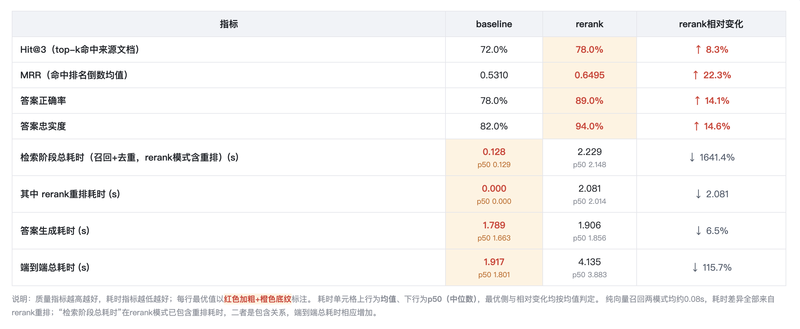
批量评测:支持正确率、忠实度、召回率等指标评估。
Web交互:在线问答与来源展示界面。
部署:支持本地化dcoker部署。
独立全链路(解析→检索→生成→评测):Python + MinerU(表格/版面还原)+ 股票图识别 + FAISS/BGE嵌入 + BGE-reranker重排 + vLLM + LangSmith(trace) + Flask(Web)。
核心设计(按数据流):①解析与跨页合并:MinerU解析加跨页表格合并和股票图识别;②两级检索:整页父文档+结构子chunk,先得chunk再回父文档拿完整上下文,防切碎丢失;③数字保真:生成答案自动核对原文关键数字,不符触发二次生成修正;④拒答检测:避免有答案时误报“资料未涉及”,全链路LangSmith trace排查。

评论