




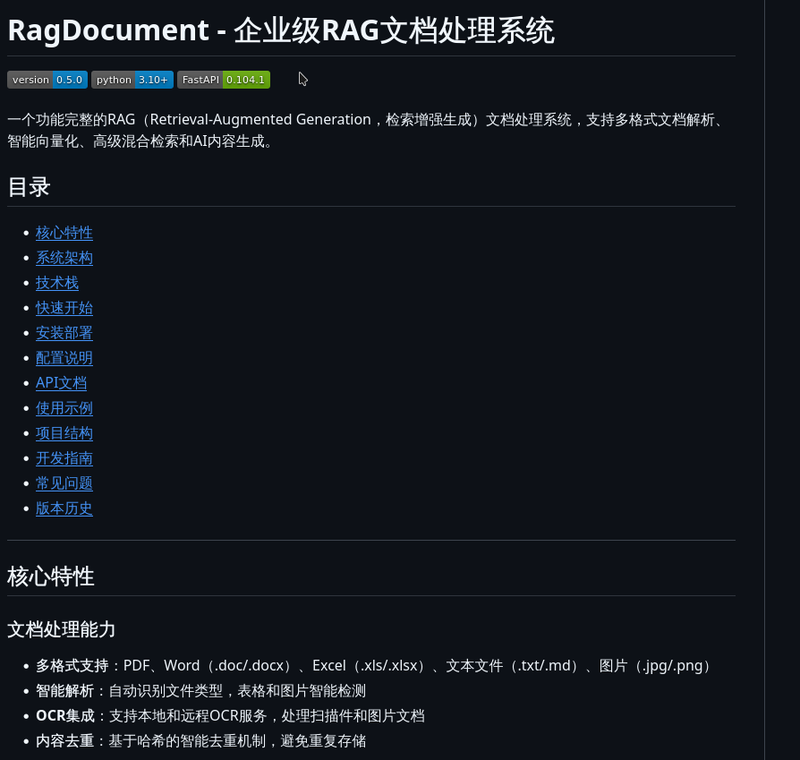
1. 文档解析:支持 PDF、Word、Excel、文本和图片,能做版面分析、表格抽取和 OCR,并按内容哈希去重。
2. 分块与向量化:父子分层分块(父块 2000 tokens、子块 500 tokens),用小块检索、大块回填上下文,向量化分批进行。
3. 混合检索:Milvus 语义检索和 MySQL 全文检索并行召回,结果用 RRF 等方式融合,配合查询改写和 Cross-Encoder 重排序,支持多轮对话的上下文。
4. 问答与长文档生成:基于检索结果回答问题;规划、内容、格式、质检四个 Agent 协作,按章节流式生成方案、标书等长文档,并做一致性检查。
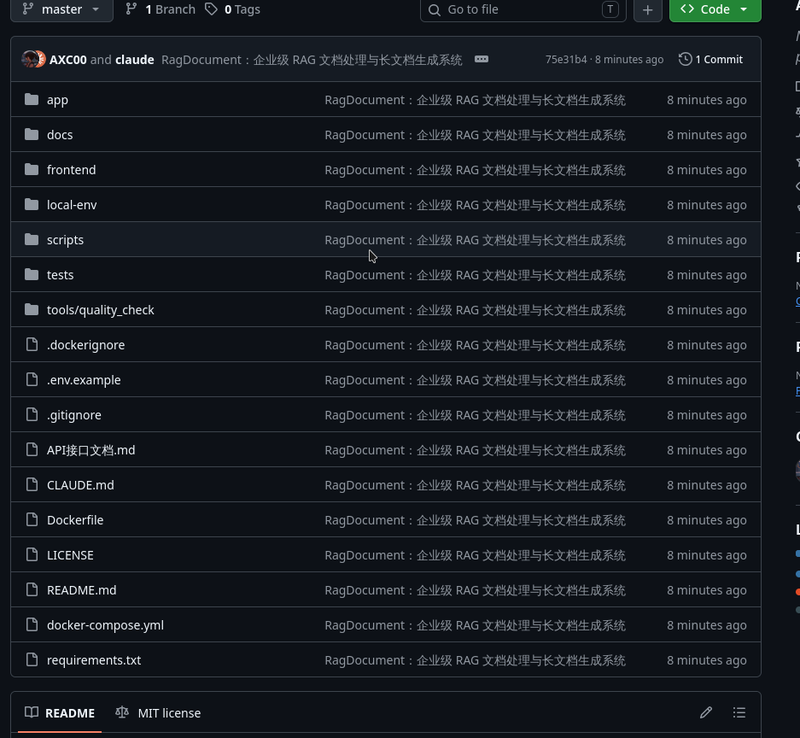
5. 评估:接入 RAGAS 评估检索和生成质量,记录 LLM 调用量。仓库附带单机复现环境和评测脚本。我用自建的 25 题评测集做检索消融,修复了 3 个缺陷:Milvus COSINE 相似度被当成距离、导致排序颠倒;Rerank 混入了无上界的全文相关度;短文档分块后被整块丢弃。修复后,混合检索 + Rerank 的 Hit@1 从 80% 提到 96%,RAGAS context_recall 从 0.64 提到 0.96。
6. Web 前端:文档管理、检索测试、问答、长文档生成、模板管理和质量检查页面。



点击空白处退出提示
评论