

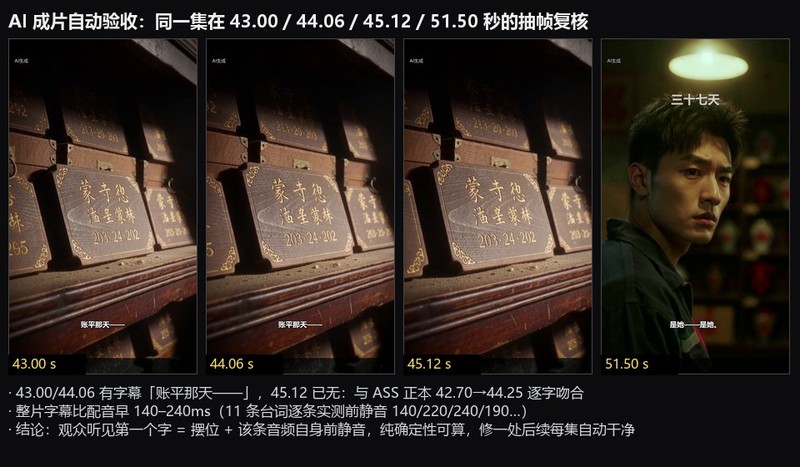
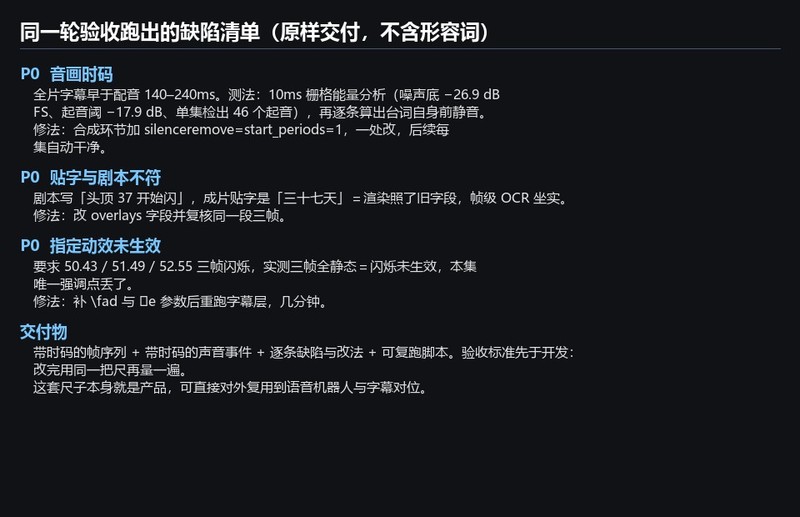
用途:AI 生成的短视频、漫剧、语音机器人在交付前做自动验收。行业背景:AI 产线一天能出十几条片,但人工复核一条 55 秒的片子要看三遍还记不住时码,缺陷漏到平台上就是掉完播率和分成。立项原因:把看片变成跑一遍脚本,成片丢进去,出来一张带时码的返修清单,写清改哪一处、这一处影响哪些集。这套东西现在跑在自己的漫剧产线上,已经抓到过字幕比配音早 140 到 240 毫秒、贴字内容和剧本不符、指定特效没生效这三类真问题,都出了返修清单。


点击空白处退出提示



用途:AI 生成的短视频、漫剧、语音机器人在交付前做自动验收。行业背景:AI 产线一天能出十几条片,但人工复核一条 55 秒的片子要看三遍还记不住时码,缺陷漏到平台上就是掉完播率和分成。立项原因:把看片变成跑一遍脚本,成片丢进去,出来一张带时码的返修清单,写清改哪一处、这一处影响哪些集。这套东西现在跑在自己的漫剧产线上,已经抓到过字幕比配音早 140 到 240 毫秒、贴字内容和剧本不符、指定特效没生效这三类真问题,都出了返修清单。
共四个模块。一、帧序列提取:按时间码把成片切成帧图,带时间戳,供逐帧比对和画面缺陷判定。二、音频事件层:本地 faster-whisper 出带时间轴的转写,再用 10 毫秒能量栅格做分析(噪声底 -26.9 dBFS、起音阈 -17.9 dB,单集检出 46 个起音),逐条算出每句台词音频的前静音。三、音画合看:把带时码的帧和带时码的音频事件放进同一次请求一起判,能看出字幕与配音不同步、贴字内容和台词不符、指定动效没生效。四、返修清单输出:每条缺陷都写成改哪一处、影响哪些集,附可复跑脚本。全流程跑在本地 CPU,不依赖云端付费接口。
我一个人做的:定判定口径、写全部代码、在自己的产线上跑到能用。技术栈是 Python 加 ffmpeg 做帧序列与音频抽取、faster-whisper 做带时间轴转写、Pillow 出证据图和清单图、OpenAI 兼容接口做多模态音画合看。难点不在识别,在口径:字幕对不上不能写感觉早了,要写成观众听见第一个字等于摆位加该条音频自身的前静音,纯确定性可算,所以修一处合成参数后面每集自动干净。亮点是证据可查,每个结论都带帧号、时码和分贝数,能直接交给制作的人复核。

评论