首页
程序员
解决方案
招聘用人
云端工作
自由工作、远程工作
企业 Agent
飞书企微接 AI,一句话查各部门情况
项目研发
需求梳理
规划落地您的想法
整包开发
一站式软件开发
作品
发布需求
开发者入驻
APP
登录
/
注册
技术
全部
Python
Java
PHP
C
C++
Android
iOS
Shell
Go
Rust
Ruby
Kotlin
Swift
Node.js
Unity3D
Object-c
Dart
Solidity
TypeScript
Perl
更多
行业
全部
人工智能
区块链
工业互联网
企业服务
金融
游戏
智能硬件
云计算
电商
开发工具
项目任务
物联网
教育校园
内容平台
机器深度学习
生活旅游
医疗健康
政务
音视频多媒体
汽车
社交
机器人
物流仓储
低代码
脚本插件
能源
网络安全
VR/AR
科学研究
边缘计算
自动驾驶
量子计算
更多
其他
类型
产品系统
全部
语言框架
开源项目
产品系统
源文件源码
系统
Linux
全部
Web
Android应用
iOS应用
小程序轻应用
Windows
MacOS
HarmonyOS应用
Linux
iPadOS
H5
车载应用
电视应用
Web3
算法模型
嵌入式硬件
LaunchBox
Vibe Coding
全部
Hadoop
视频推荐系统
产品系统
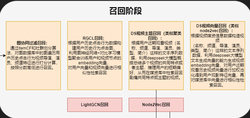
1、数据处理-图数据库相关数据处理2、特征工程-对多源特征进行处理,特征编码3、召回-多路召回通路模型4、精排-多个深度学习精排模型5、重排-重排算法及策略
58
0
Python
人工智能
超大规模分布式主题模型(Topic Model)推理与芯片级协同优化系统
产品系统
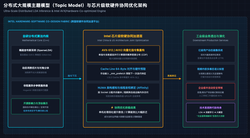
1.核心自研大规模并行主题模型引擎:自主设计并实现支持超大规模词表与高维主题空间的无监督分布式LDA推理算法,实现对百亿级海量非结构化文本的低延迟主题抽取与降维表征;2.软硬件深度协同优化:与国际顶尖芯片厂商(Intel跨国团队)深度联合技术攻关,基于硬件微架构深度压榨CPU缓存行(CacheLin
108
0
C++
人工智能
大规模流媒体分布式实时计算与DAG算子化调度系统
产品系统
1.算子化(Operator)设计与解耦:将底层召回、特征抽取、模型粗排、业务过滤等复杂计算任务拆解为高内聚、低耦合的标准算子节点,彻底消除了业务新增策略时的重复开发成本;2.高性能DAG调度引擎:自主构建有向无环图(DAG)任务拓扑调度内核,支持跨计算节点的自动并发执行、依赖解析与动态拓扑分支选择
83
0
C++
云计算
电商实时推荐舆情监控系统
产品系统
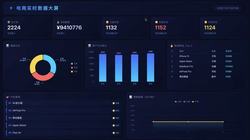
本项目实现六大核心功能:①用户行为实时统计(PV/UV);②基于ALS模型的个性化商品推荐;③基于朴素贝叶斯的评论情感分析;④负面舆情实时监控与预警;⑤Kafka双Topic解耦行为与评论数据流;⑥Flask+ECharts大屏动态展示实时流量、热门排行、推荐列表、情感分布、预警及吞吐量六大模块。
189
0
Python
人工智能
企业Ai智能体
产品系统
企业知识库:构建多源异构数据接入层,支持文档(PDF/Word/Excel/PPT/TXT)、数据库(MySQL/PG等结构化元数据)、视频流(音视频转录与语义索引)的统一导入、解析与向量化存储,形成企业专属知识图谱。AIAgent智能体:支持文本/语音多模态交互,融合LLM推理与工具调用能力,实现
152
0
Java
人工智能
阿里云 docker 部署
产品系统
Vibe Coding
自动化环境初始化:使用Bash脚本完成yum源切换(vault.centos.org)、基础工具安装(vim/git/net-tools)、内核参数优化;容器化服务部署:基于DockerCompose编排Nginx+PythonFlask+MySQL三件套,实现服务解耦与快速扩缩容;安全加固模块:配
139
0
Java
云计算
Pallas 分布式小文件存储系统
产品系统
Pallas是自主研发的分布式小文件存储系统,核心功能模块包括:1)Master/Worker主从架构,支持基于ZooKeeper的Master选举与高可用;2)Namespace(命名空间)与Bucket(桶)两级元数据管理,支持创建、查询、更新、删除及配额(Quota)与QPS限流;3)基于HB
171
0
Java
人工智能
IFRS17新财务准则数据平台实施项目
产品系统
本项目构建了完整的IFRS17财务数据平台,核心功能模块包括:**1.数据探源与接入模块**:对接保险核心业务系统、再保系统、精算系统等10余个源系统,完成保单级、赔案级、费用级明细数据的全量抽取与增量同步。**2.数据标准化与校验模块**:设计标准数据模型,实现源系统数据到标准模型的映射转换;构建
224
0
Python
金融
基于头条巨量引擎,百度营销和阿里汇川爬虫
产品系统
项目名称:项目三:基于头条巨量引擎,百度营销和阿里汇川爬虫软件架构:python3,cv2(open-cv),muggle-ocr,pyppeteer项目描述:主要运用多进程和多协程通过opencv和muggle-ocr绕过滑动验证码以及复杂图片的验证,实现自动化入库投放渠道信息,通过spark和p
213
0
Python
云计算
风控监控与预警平台
产品系统
软件架构:python3,scala,spark,flink,实时数仓,离线数仓项目描述:主要通过spark构建离线数仓和flink构建实时数仓来实现风险监控、风险预警和风险数仓,通过监控指标和归因指标以及数仓建模实现自动预警,高效反馈关键考核指标的变化因素,支持风险团队的快速分析,高效定位问题,以
241
0
Python
云计算
大数据平台
产品系统
项目名称:项目一:开发大数据平台,基于大数据平台做用户画像软件架构:flink,hadoop,spark,presto,java,python3,mapreduce,shell,kafka,sklearn,doplinscheduler项目描述:每天从百度上百亿数据刻画用户画像来提高用户续费率。责任
225
0
Python
云计算
当前共11个项目
登录查看更多
登录
登录后即可上传、下载作品
分类
Python
Zig
UML
ActionScript
Lua
算法设计
HTTP2
HDFS
SpringMVC
Taro
×
寻找源码
源码描述
联系方式
提交
重点城市程序员兼职推荐
北京程序员兼职
上海程序员兼职
深圳程序员兼职
广州程序员兼职
杭州程序员兼职
成都程序员兼职
南京程序员兼职
武汉程序员兼职
西安程序员兼职
重庆程序员兼职
郑州程序员兼职
长沙程序员兼职
苏州程序员兼职
合肥程序员兼职
厦门程序员兼职
济南 程序员兼职
青岛程序员兼职
天津程序员兼职
大连程序员兼职
福州程序员兼职
石家庄程序员兼职
沈阳程序员兼职
太原程序员兼职
无锡程序员兼职
南昌程序员兼职
哈尔滨程序员兼职
南宁程序员兼职
珠海程序员兼职
宁波程序员兼职
昆明程序员兼职
东莞程序员兼职
贵阳程序员兼职
美国程序员兼职
长春程序员兼职
温州程序员兼职
佛山程序员兼职
常州程序员兼职
呼和浩特程序员兼职
兰州程序员兼职
乌鲁木齐程序员兼职
中山程序员兼职
海口程序员兼职
洛阳程序员兼职
更多
重点岗位程序员兼职推荐
C++兼职
Rust兼职
小程序兼职
cocos2d-x兼职
Unity3D兼职
DBA兼职
运维兼职
测试兼职
Go兼职
UE设计师兼职
全栈兼职
技术创始人兼职
CTO兼职
架构师兼职
产品经理兼职
PHP兼职
Java兼职
C兼职
C#兼职
Python兼职
Ruby兼职
Node.js兼职
项目经理兼职
Android兼职
iOS兼职
前端兼职
UI设计师兼职
原画师兼职
嵌入式兼职
Vibe Coding兼职
fde兼职
HarmonyOS兼职
区块链兼职
人工智能兼职
硬件开发兼职
移动其他兼职
更多