

项目面向实体书籍、纸质资料及文档数字化场景,主要解决传统拍照扫描过程中页面裁剪繁琐、图片倾斜、书页变形、双页混合以及后续文字整理效率低等问题。通过扫描、图像处理和OCR识别,将纸质内容转化为可保存、检索和进一步处理的电子内容,可用于个人资料整理、书籍电子化、学习资料归档以及后续AI文本分析等场景。


点击空白处退出提示



项目面向实体书籍、纸质资料及文档数字化场景,主要解决传统拍照扫描过程中页面裁剪繁琐、图片倾斜、书页变形、双页混合以及后续文字整理效率低等问题。通过扫描、图像处理和OCR识别,将纸质内容转化为可保存、检索和进一步处理的电子内容,可用于个人资料整理、书籍电子化、学习资料归档以及后续AI文本分析等场景。
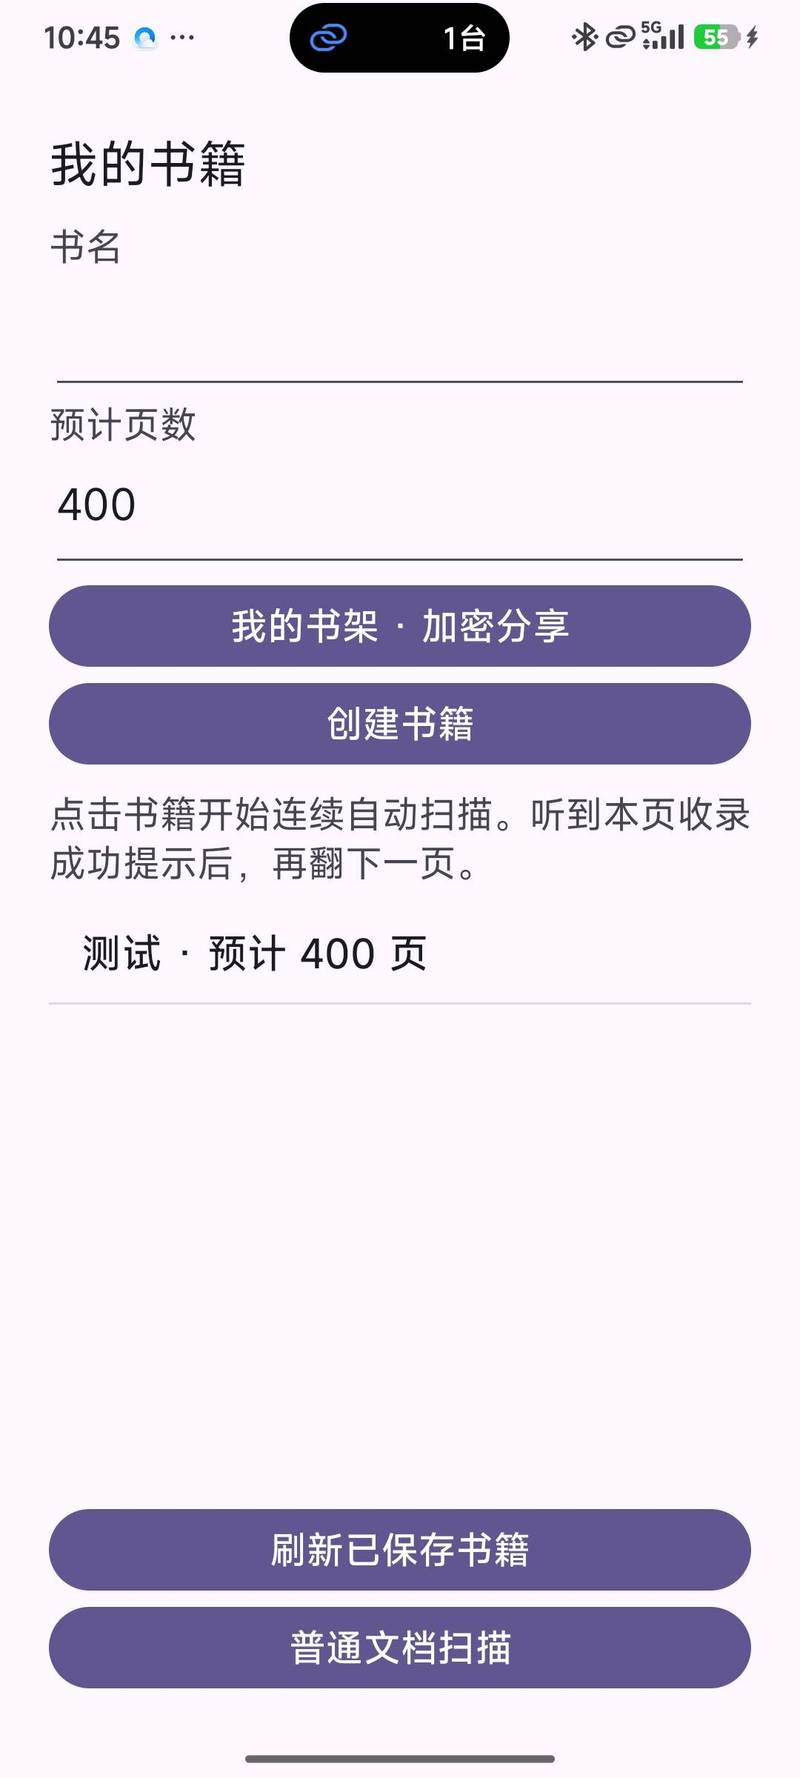
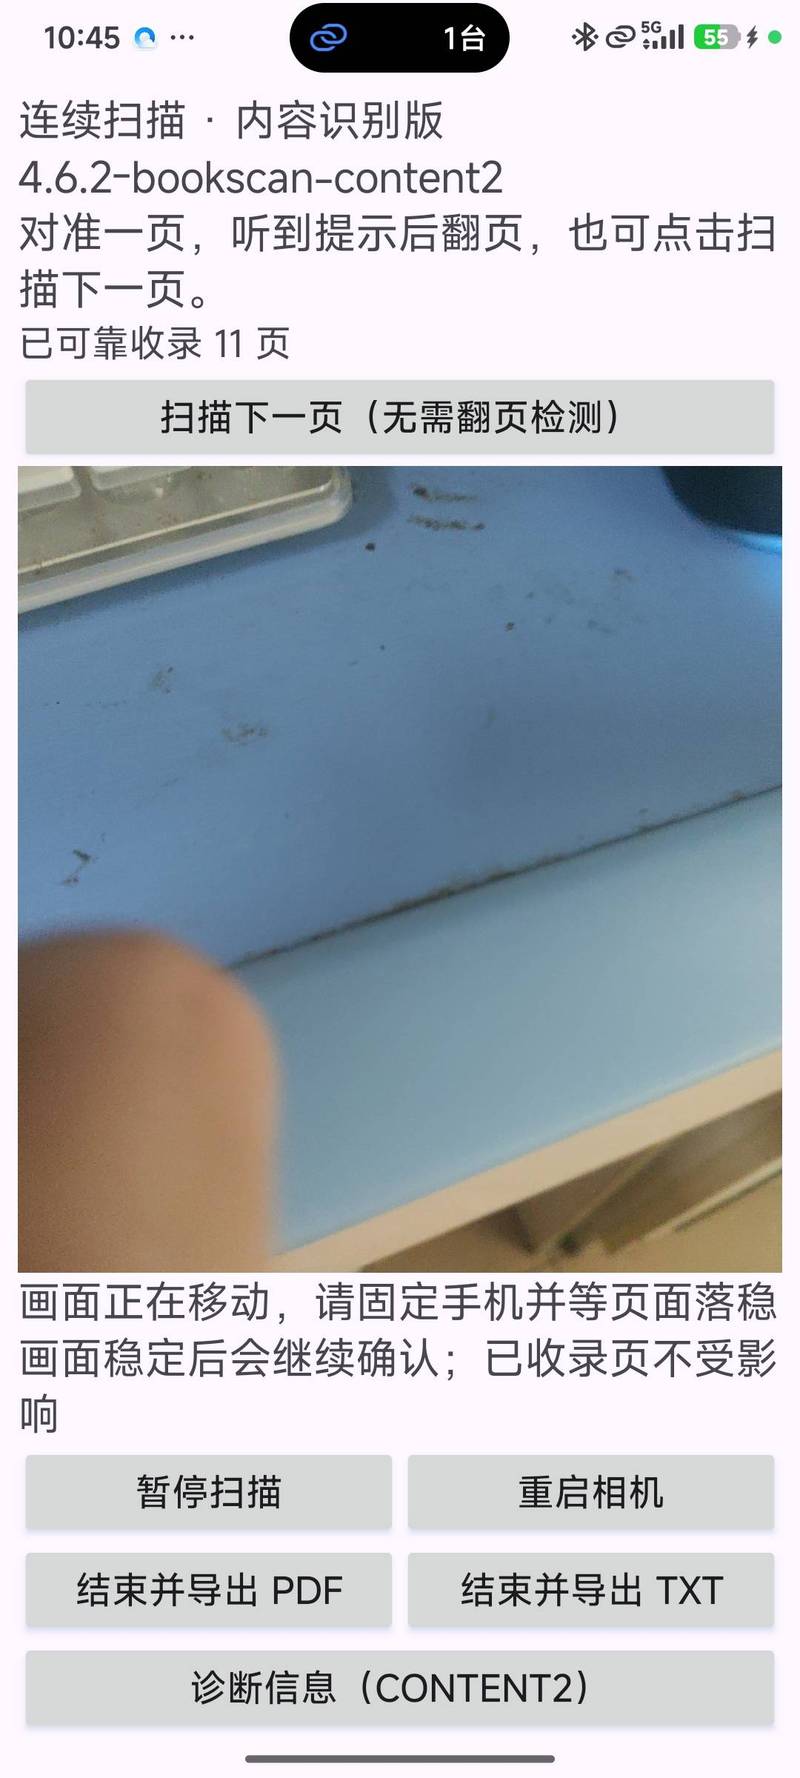
系统包含图片导入、页面检测、自动裁剪、透视矫正、双页拆分、图像增强、OCR文字识别、页面排序及电子文档导出等功能。针对实体书连续扫描场景,可将拍摄得到的原始页面自动处理为更加规整的文档,并进一步提取文字内容,减少传统扫描流程中的人工操作。处理结果可用于电子书制作、资料归档、文本检索以及后续大模型分析。
个人独立完成项目需求分析、功能拆解、开发流程设计、AI辅助编码、测试和迭代。针对实体书扫描场景,将完整流程拆分为图像输入、页面检测、图像预处理、OCR识别、结果整理和文件输出等模块,并使用Codex辅助完成代码实现及问题排查。开发过程中重点处理扫描图片质量不稳定、页面边缘识别、文字识别结果整理以及多步骤处理流程衔接等问题,同时通过实际样本反复测试和调整处理效果。项目采用模块化方式设计,便于后续继续增加书页矫正、识别优化、批量处理和AI文本分析能力。

评论