全国大学英语四六级考试每年有上千万考生,词汇是阅读、听力、写作得分的基础,背词是最刚需的备考场景。但现有背词产品有两个长期痛点:一是词表与真题脱节——或求大求全让学生背大量低频词,或用机械字数标准凑释义,词典腔严重,与试卷真实语言不符;二是学习方式依赖“看答案自评”,学习者对自己是否真正掌握判断不准,产生“我本来就会”的错觉,复习效率被高估。本项目旨在从 200 万句四六级真题语料出发,用统计挖掘驱动词表、释义与例句的生产,让每一分钟学习都投在真实考点上,实现“用最少的词撬动最高的分”。
平台是本地优先、可离线安装的 PWA 应用,核心功能模块:
1. 单词书——覆盖四级/六级全量词库(10993 词),按“真题词频降序+功能词穿插”智能排序,支持掌握阶段筛选与每词闪击次数台账;
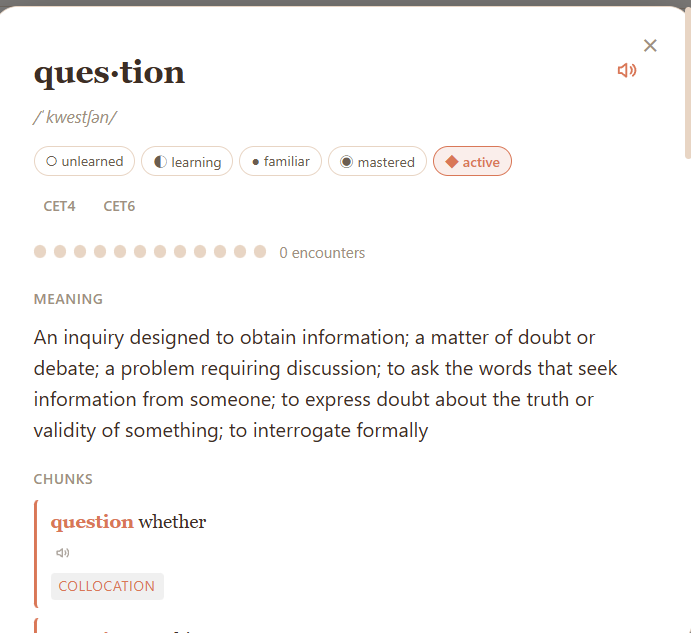
2. 闪击闪卡——限时逼真回想,先自主回忆再看答案,支持音节拆分显示与美/英音朗读;
3. 验证练习——四选一与拼写验证,杜绝翻答案式自评;
4. 例句系统——5.5 万条例句按义项分组展示,多义词各义项一目了然;
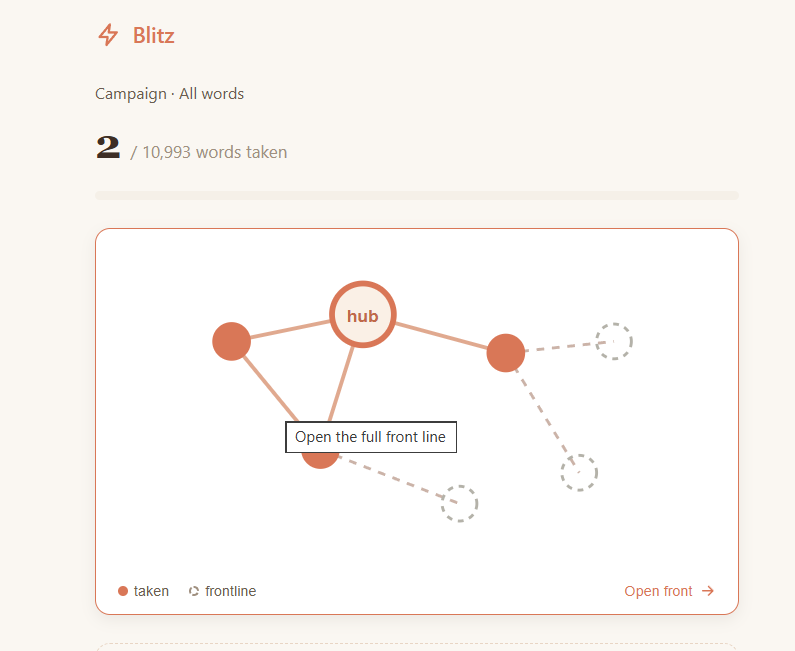
5. 词关系图谱——基于 D3 的同义/搭配/派生关系可视化;
6. 真题阅读与发音跟读模块;
7. 学习统计——基于 Recharts 的复习曲线与掌握度报表;
8. 个性化设置——主题、音节分隔符、朗读语速等可配置。
我独立完成了从产品设计、数据工程到前端开发的全流程。
技术栈:React 19 + TypeScript + Vite 8 + Tailwind CSS 4 + PWA + Dexie(IndexedDB) + Zustand + React Router 7,可视化用 D3/Recharts,测试用 Vitest + oxlint,数据管线为 Python 脚本集。
具体任务与技术亮点:
1. 数据工程:自建真题语料处理管线,对 200 万句语料做解析、清洗、义项归类(senseIdx 标注)与真实性/相关性/义项契合/学习价值四层过滤,产出 10993 词、55792 例句、地道释义等结构化数据资产;
2. 释义质量工程:编写词典腔、同根循环等脏释义检测器,搭建“多代理并行改写 + 自动 QC + 中心接入”流水线,实现全库释义地道化并统一四六级同词释义;
3. 性能与体验:设计“静态壳先行 + 后台水合 IndexedDB”架构,首屏渲染不被万级数据阻塞;SEED_VERSION 版本化播种,数据升级不丢用户学习进度;
4. 架构设计:全应用仅一个调度函数(排班员)决定卡片出场时机,业务逻辑抽离为纯函数模块并配单元测试。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!
下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态




评论