

中小企业与大模型应用团队接入 LLM 能力时普遍面临三难:本地推理需要 GPU 硬件,直接调用多家云厂商 API 又缺乏统一管理,上线后没有调用统计与成本管控。本项目从零实现轻量级 LLM 推理服务与 LLMOps 网关平台:通过 OpenAI 兼容协议统一代理通义 DashScope、DeepSeek 等云端大模型 API(也支持本地 vLLM),2 核 4G 普通服务器即可承载、无需 GPU,定位为 AI 应用后端的基础设施,解决模型统一接入、流量管控与可观测性问题。

点击空白处退出提示
中小企业与大模型应用团队接入 LLM 能力时普遍面临三难:本地推理需要 GPU 硬件,直接调用多家云厂商 API 又缺乏统一管理,上线后没有调用统计与成本管控。本项目从零实现轻量级 LLM 推理服务与 LLMOps 网关平台:通过 OpenAI 兼容协议统一代理通义 DashScope、DeepSeek 等云端大模型 API(也支持本地 vLLM),2 核 4G 普通服务器即可承载、无需 GPU,定位为 AI 应用后端的基础设施,解决模型统一接入、流量管控与可观测性问题。
① 模型管理:统一注册、版本切换、热加载,多模型并存一键切换;
② 请求限流:令牌桶 / 滑动窗口 / Redis 分布式限流;
③ 响应缓存:基于 Prompt 哈希的 Redis / 内存 LRU 缓存,命中直接返回;
④ 并发控制:信号量限流最大并发,超时快速失败;
⑤ 监控统计:调用日志、P50/P95/P99 延迟、token 统计、错误率告警、Prometheus 导出;
⑥ Prompt 版本管理与 A/B 测试:模板版本化、按用户哈希稳定分流、指标对比;
⑦ 全可插拔架构,新增实现零侵入;
⑧ Docker Compose 一键部署,内置 Swagger 面板在线调试。
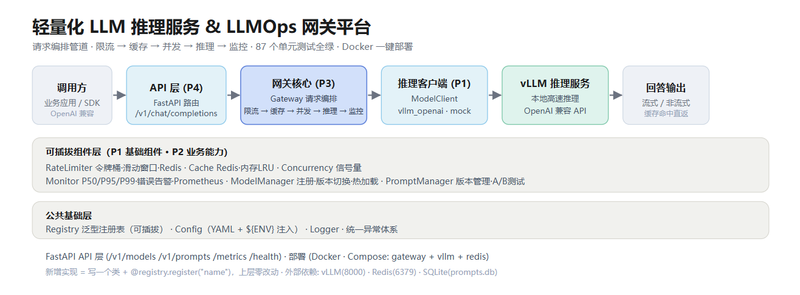
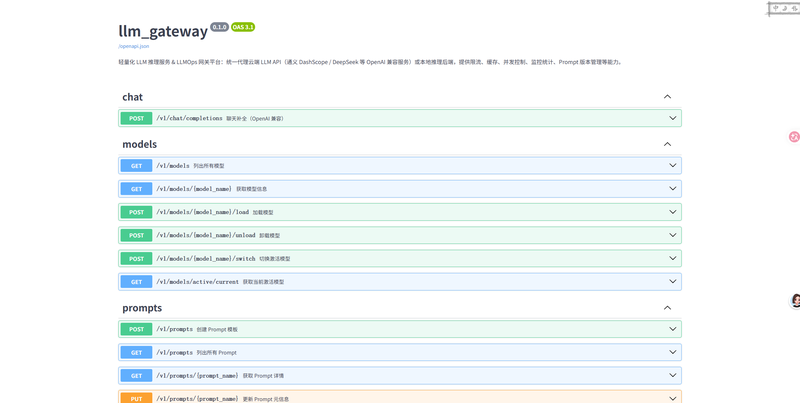
五层可插拔架构(P0 公共设施→P1 基础组件→P2 业务能力→P3 网关核心→P4 API 层),每层 "抽象基类 + Registry+@register + 配置选型",新增实现不改上层代码。核心链路:限流→缓存→并发→推理→监控全链路埋点。推理客户端支持 openai_compatible(云端)/vllm_openai/mock 三种后端。88 个单元测试全绿,已部署公网 HTTPS([gateway.weiguangtech.com](https://gateway.weiguangtech.com)),Swagger 面板在线可调 /chat、/models、/metrics,真实转发云端模型验证通过。

评论